Módulo 26. Agentes adaptativos y aprendizaje
256.1. Elegir también determina qué se aprende
Un agente que elige una acción obtiene consecuencias y, con frecuencia, información. Esa doble función crea una tensión entre usar la alternativa que actualmente parece mejor y probar otra para reducir la incertidumbre. La exploración y el aprovechamiento describen aspectos de esa decisión, que no siempre corresponden a dos conductas separadas.
Una acción puede ser a la vez prometedora e informativa; otra puede ser nueva y poco informativa. Explorar no equivale simplemente a variar al azar, del mismo modo que aprovechar no implica actuar con certeza.
El problema depende del horizonte. Si queda una sola elección, una observación que solo será útil después carece de valor instrumental dentro de ese objetivo. Si quedan muchas decisiones, aceptar una pérdida inmediata puede mejorar resultados posteriores. La misma acción puede ser conveniente al comienzo y dejar de serlo al final.
También depende de cómo cambia el entorno. En un sistema estacionario, la evidencia acumulada puede justificar reducir la exploración. Si las oportunidades se transforman, dejar de observar una opción puede impedir detectar que mejoró. Una política adecuada para aprender una distribución fija no necesariamente sirve para seguir un objetivo móvil.
Los problemas de bandidos son una formulación controlada de esta tensión. Cada acción produce recompensas de una distribución y el agente solo observa, en la versión básica, el resultado de la elegida. Thompson estudió tempranamente la asignación basada en incertidumbre posterior [1] y trabajos posteriores establecieron garantías para políticas concretas bajo supuestos explícitos [2].
Usaremos ejemplos exactos para comparar la aleatoriedad, el optimismo frente a la incertidumbre y el muestreo posterior. También separaremos maximizar la recompensa durante el aprendizaje de identificar la mejor opción al terminar un experimento; ambos objetivos son legítimos, pero pueden requerir distribuciones de esfuerzo diferentes.
La pregunta principal será qué experiencia merece producirse ahora, considerando su costo y su posible utilidad futura. Responderla exige un modelo de información, más allá de una preferencia general por la novedad. También exige distinguir la incertidumbre reducible mediante observaciones de la variabilidad que permanecerá aunque conozcamos perfectamente el entorno. Probar repetidamente una opción muy variable no elimina necesariamente esa variabilidad, aunque puede permitir estimar mejor su distribución.
256.2. Un ejemplo donde el horizonte cambia la decisión
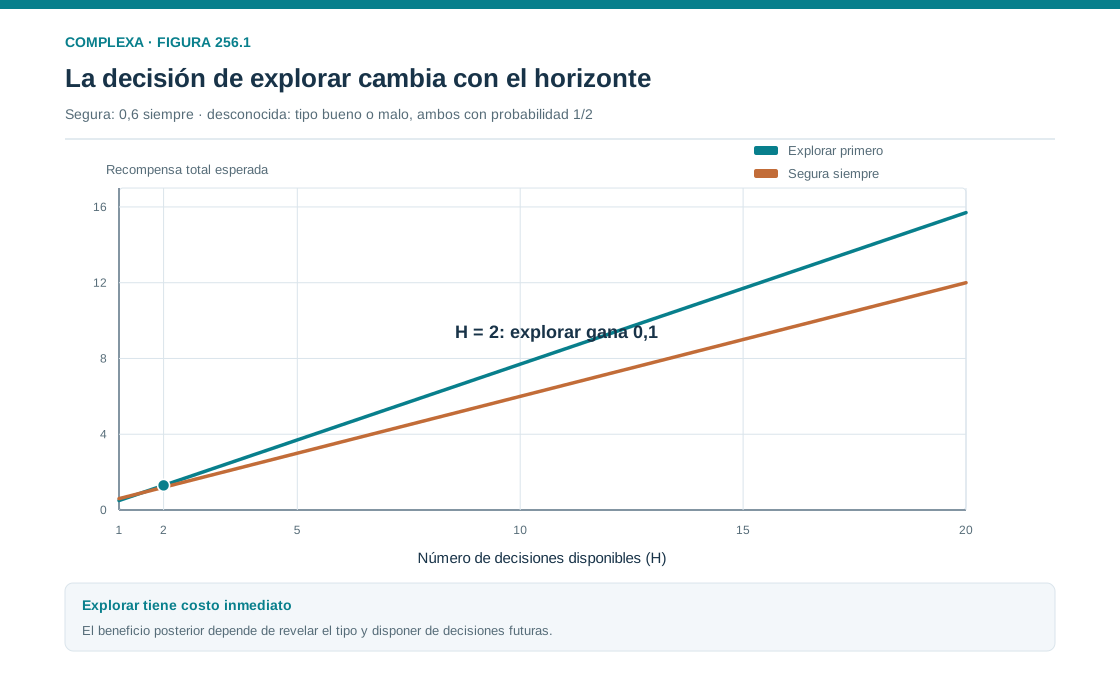
Consideremos una opción segura que entrega siempre 0,6 unidades. La otra opción es desconocida y pertenece a uno de dos tipos (entrega siempre uno o siempre cero). Antes de probarla, asignamos probabilidad de un medio a cada tipo. Una sola observación revela su tipo perfectamente y este no cambia después.
Con una única elección disponible, la opción segura tiene valor 0,6 y la desconocida valor esperado 0,5, de modo que elegir la segura maximiza la recompensa esperada. La información obtenida al probar la desconocida no puede usarse en ninguna decisión posterior dentro del horizonte.
Con dos elecciones, probar primero la desconocida produce recompensa media 0,5. Si resulta buena, elegimos otra vez esa opción y obtenemos uno. Si resulta mala, pasamos a la segura y obtenemos 0,6. El total esperado es .
Elegir siempre la segura produce 1,2. Por tanto, explorar primero tiene una ventaja esperada de 0,1 aunque su recompensa inmediata sea inferior. La diferencia procede solo de usar la información en la segunda elección.
Con elecciones y exploración inicial, el total esperado es . Después de revelar el tipo, la recompensa esperada por paso es 0,8, promedio entre uno en el caso favorable y 0,6 en el desfavorable. La política siempre segura produce .
En este ejemplo, la exploración inicial supera a la seguridad constante cuando el horizonte entero es al menos dos. Retrasar la prueba hasta después de una elección segura pierde parte del tiempo en que podría aprovecharse una opción buena. Bajo los supuestos dados, si conviene probar, hacerlo antes permite usar antes la información.
La conclusión depende fuertemente de que una observación revele el tipo sin error y de que la opción no cambie. Con resultados ruidosos podrían requerirse varias pruebas; un costo adicional de experimentar elevaría el umbral de horizonte. Si la opción pudiera deteriorarse al usarla, la información y el recurso quedarían acoplados.
El ejemplo muestra que una acción de menor recompensa inmediata puede ser óptima por su valor informativo. De él no se sigue que cualquier exploración sea beneficiosa ni que siempre convenga comenzar por la opción más incierta.
256.3. Medir el costo de aprender
Una medida habitual compara la recompensa esperada del agente con la de un referente que conoce la mejor opción desde el comienzo. En un bandido estacionario con medias , el pseudorregret esperado, suma de las diferencias entre la mejor media y la media de la acción elegida acumuladas durante el horizonte, puede escribirse como
El contador indica cuántas veces se eligió cada acción. La expresión evalúa decisiones en promedio bajo un entorno definido. No equivale a la diferencia observada entre dos trayectorias aleatorias concretas, que puede fluctuar e incluso favorecer accidentalmente una política inferior.
En el ejemplo de A con media 0,8 y B con media 0,4, cada elección de B contribuye 0,4 al pseudorregret. Si B se elige diez veces en cien decisiones, la contribución es cuatro. El cálculo usa las medias verdaderas y el número de elecciones, sin las recompensas particulares observadas.
El referente tiene información de la que el aprendiz carece. Por eso, una pérdida inicial no demuestra un error evitable; puede ser el costo de descubrir las medias. La pregunta es cómo crece esa pérdida con el tiempo y cómo depende de las diferencias entre alternativas.
En el ejemplo de la sección 256.2, un referente informado obtiene recompensa media 0,8 por paso antes de revelar el tipo. La política que prueba primero y luego usa lo aprendido pierde, en promedio, 0,3 unidades en total para horizontes donde se aplica. La pérdida no crece después porque la incertidumbre se resuelve con una observación.
Otros problemas no permiten esa resolución perfecta. Si dos acciones tienen medias muy próximas y resultados variables, distinguirlas puede requerir muchas observaciones. La política debe entonces equilibrar cuánto invertir en esa distinción cuando el beneficio de elegir correctamente es pequeño.
Conviene informar distribuciones y riesgos además de promedios. Dos políticas con igual recompensa esperada pueden diferir en la probabilidad de obtener resultados muy bajos durante el aprendizaje. Si esas consecuencias importan para la tarea, una métrica única de regret no resume todo el problema.
El criterio debe declararse antes de comparar algoritmos. Maximizar la recompensa acumulada, minimizar los errores finales y respetar una restricción de seguridad son objetivos diferentes. Una política puede destacar en uno y ser inadecuada en otro.
256.4. Exploración aleatoria y sus límites
Una estrategia sencilla introduce elecciones aleatorias con una probabilidad fija. En una política épsilon-voraz, el agente aprovecha sus estimaciones la mayor parte del tiempo y selecciona uniformemente una acción durante los pasos de exploración. La regla es fácil de implementar, pero no dirige necesariamente las pruebas hacia la incertidumbre más relevante.
Si A es la mejor acción estimada entre dos y , A se elige con probabilidad 0,9 y B con 0,1. Una vez identificado correctamente el orden verdadero de medias 0,8 y 0,4, la recompensa esperada es 0,76. Mantener esa exploración genera una pérdida esperada de 0,04 por paso respecto de elegir siempre A.
Durante el aprendizaje, esa pérdida puede financiar información. Después, en un entorno estacionario, una tasa fija sigue probando alternativas aunque haya evidencia abundante de su inferioridad, de modo que el costo acumulado puede crecer linealmente. Reducir la tasa con el tiempo busca limitar ese efecto, pero exige cuidado para no abandonar demasiado pronto opciones mal estimadas.
Si la probabilidad de explorar cae demasiado rápido, una mala experiencia inicial puede dejar una opción valiosa sin suficientes visitas. Las garantías de convergencia requieren condiciones sobre la exploración, la actualización y el entorno; una curva que disminuye visualmente no es una demostración.
La selección uniforme tampoco distingue entre opciones. Si una alternativa es claramente mala y otra permanece incierta cerca de la mejor, repartir las pruebas por igual puede desperdiciar recursos. Las estrategias dirigidas usan la distribución de incertidumbre o indicadores de confianza para decidir qué acciones probar.
La aleatoriedad puede servir además para impedir que una política sea completamente predecible o para diversificar experiencias bajo un modelo imperfecto, aunque esa utilidad debe evaluarse en el problema correspondiente. No toda variabilidad conductual es una búsqueda deliberada de información ni toda exploración necesita parecer aleatoria.
También influyen los empates y la inicialización. Bajo una política voraz, valores iniciales optimistas pueden inducir pruebas de opciones no visitadas, aunque el efecto depende de cómo se actualizan y de si el entorno cambia. Una vez descartada una opción, el optimismo inicial no garantiza que vuelva a examinarse.
Por su sencillez, la exploración aleatoria es una referencia útil para preguntar si dirigir la búsqueda de información compensa su costo y sus supuestos adicionales.
256.5. Optimismo frente a incertidumbre
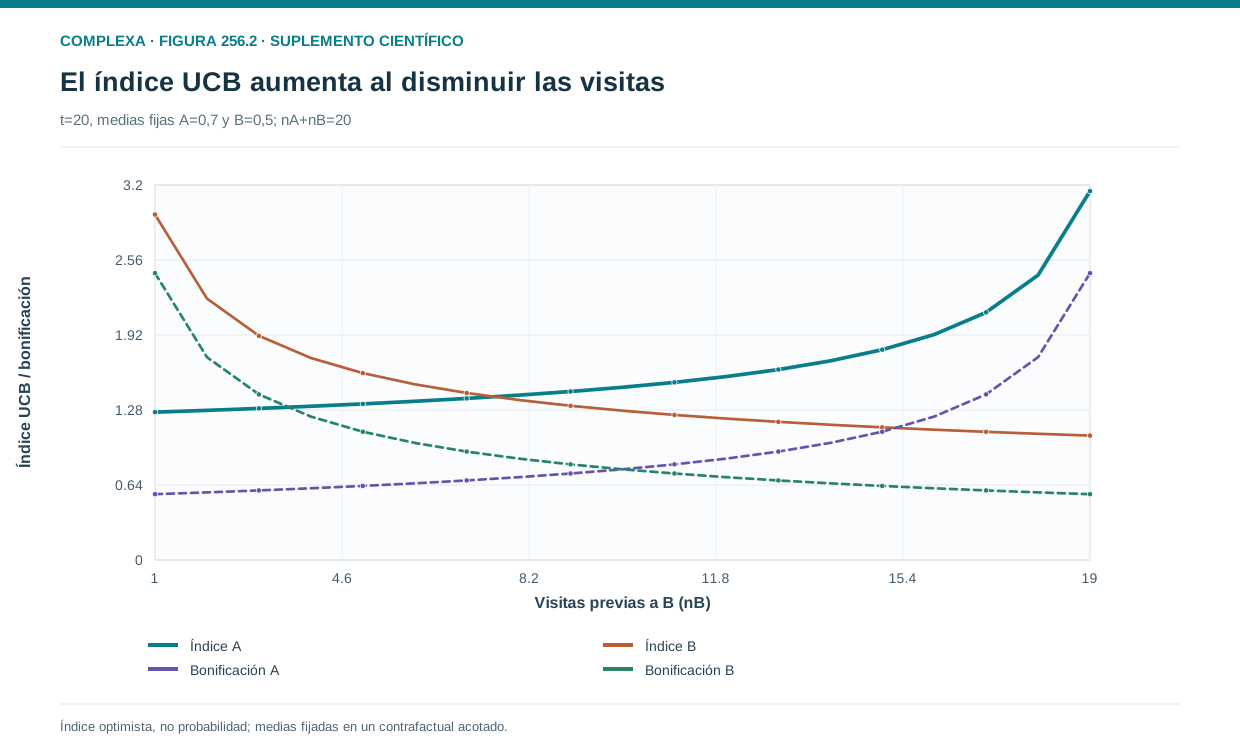
Las políticas de límite superior de confianza asignan a cada acción una estimación de recompensa más una bonificación que crece con la incertidumbre. El agente elige la mayor suma. Una acción poco observada puede resultar atractiva porque todavía podría ser mejor de lo que indica su media empírica.
En UCB1, después de una inicialización que prueba cada acción, el índice combina la media empírica y un término proporcional a la raíz del logaritmo del tiempo dividido por el número de visitas. Para recompensas acotadas entre cero y uno, una forma estándar es
Auer, Cesa-Bianchi y Fischer analizaron esta política en un bandido estocástico estacionario y establecieron cotas de regret bajo sus supuestos [2]. La fórmula no debe trasladarse sin revisión a recompensas de escala arbitraria, dependencias temporales o procesos donde las acciones alteran otras distribuciones.
Como el índice suma una bonificación a la media empírica, puede superar uno aunque las recompensas estén entre cero y uno. Es un criterio de elección optimista y leerlo como probabilidad sería un error.
Consideremos veinte observaciones previas, dieciocho de A y dos de B, con medias empíricas de 0,7 y 0,5. Si usamos en la convención declarada, el índice de A es aproximadamente 1,277 y el de B aproximadamente 2,231. La regla favorece a B por su menor cantidad de información, aunque eso no indica que B sea realmente mejor. Con más observaciones su bonificación disminuye y, si las recompensas confirman una media baja, el agente vuelve a concentrarse en A.
La convención temporal debe ser coherente con la implementación. Algunos programas cuentan las decisiones realizadas y otros la decisión siguiente. Esa diferencia pequeña puede cambiar una cifra intermedia, aunque no altere la idea general; para una reproducción exacta se documenta el contador usado.
El optimismo también puede aplicarse a modelos de transición, con una estructura más compleja. La bonificación debe reflejar cómo la incertidumbre afecta los retornos, además de las recompensas inmediatas. Una extrapolación informal desde bandidos a decisiones secuenciales puede producir incentivos extraños.
La ventaja del enfoque es dirigir las pruebas hacia alternativas plausiblemente competitivas. Su límite es que la confianza depende de supuestos estadísticos y de datos pertinentes. Una cota calculada para un entorno estacionario puede ser demasiado estrecha después de una ruptura.
256.6. Muestrear hipótesis para decidir
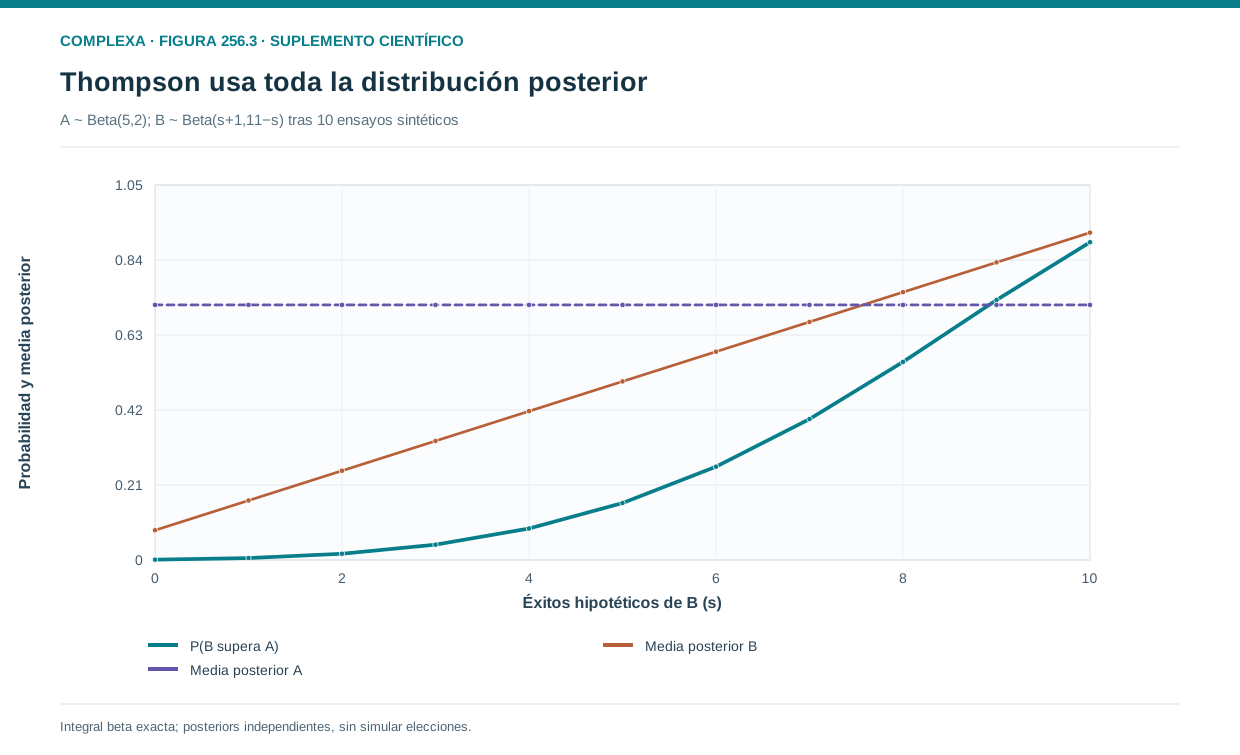
El muestreo de Thompson usa una distribución posterior sobre parámetros desconocidos. En cada decisión toma una muestra de esos parámetros y elige la acción que sería mejor bajo la muestra. La aleatoriedad procede de la incertidumbre inferencial [1]; en la política épsilon-voraz procedía de una probabilidad uniforme de desviarse de la mejor estimación.
Para recompensas Bernoulli, un ejemplo conjugado usa una distribución beta para la probabilidad de éxito de cada acción. Con prior beta de parámetros uno y uno, observar éxitos y fracasos produce una posterior beta de parámetros y . El agente toma una probabilidad de cada posterior y elige la mayor.
Supongamos que A acumula cuatro éxitos y un fracaso, mientras B acumula un éxito y ningún fracaso. Las posteriores son beta de parámetros cinco y dos para A y de parámetros dos y uno para B, con medias de cinco séptimos y dos tercios. A tiene media mayor, pero B conserva una incertidumbre considerable debido a su muestra pequeña.
La regla puede seleccionar B cuando una muestra posterior le asigna una probabilidad superior. Esa elección refleja que el agente todavía atribuye probabilidad a escenarios donde B es mejor. A medida que se acumula evidencia, la distribución de elecciones cambia.
Bajo posteriores continuas y sin empates, la probabilidad de elegir una acción coincide con la probabilidad posterior de que sea óptima en ese modelo. Esa coincidencia no implica que el procedimiento resuelva exactamente toda planificación bayesiana de horizonte finito, porque la probabilidad de optimalidad inmediata y el valor de la información a largo plazo son conceptos relacionados, pero distintos.
El prior importa cuando hay pocos datos. Una distribución inicial concentrada puede retrasar la revisión; una mal especificada puede excluir posibilidades reales. También importan las dependencias entre acciones. Si las recompensas comparten parámetros, actualizar una opción puede dar información sobre otras y la posterior conjunta debe reflejarlo.
En el ejemplo de posteriores beta podemos calcular exactamente la frecuencia de elección prevista. La distribución beta de parámetros dos y uno tiene función acumulada igual al cuadrado de su argumento. Condicionada a una muestra de A, la probabilidad de que esta supere la muestra de B es entonces ese cuadrado. Al promediar respecto de la posterior de A obtenemos su segundo momento, treinta dividido por cincuenta y seis, que equivale a quince veintiochoavos (aproximadamente 0,536).
Por tanto, A se seleccionaría en torno al 53,6 por ciento de decisiones repetidas con esas posteriores congeladas y B en torno al 46,4 por ciento. Este experimento de verificación difiere de una secuencia normal de aprendizaje, en la que las posteriores cambian después de cada resultado y, con ellas, las frecuencias de elección. El cálculo es una referencia exacta para comprobar el muestreador. Muestra además que la probabilidad de elección depende de toda la distribución de incertidumbre representada, de la que la diferencia de medias es solo un rasgo.
La implementación requiere generar muestras correctamente y registrar qué información estaba disponible antes de decidir. Usar datos del futuro para actualizar la posterior produciría una evaluación optimista inválida. En comparaciones sintéticas podemos comprobar momentos de las distribuciones y frecuencias de selección en casos simples.
El muestreo posterior es una forma coherente de dirigir la exploración según la incertidumbre modelada; su calidad depende de esa modelación. Una posterior muy precisa sobre un modelo incorrecto puede concentrar decisiones de manera equivocada, igual que una confianza frecuentista mal aplicada.
256.7. Aprender para actuar y experimentar para identificar
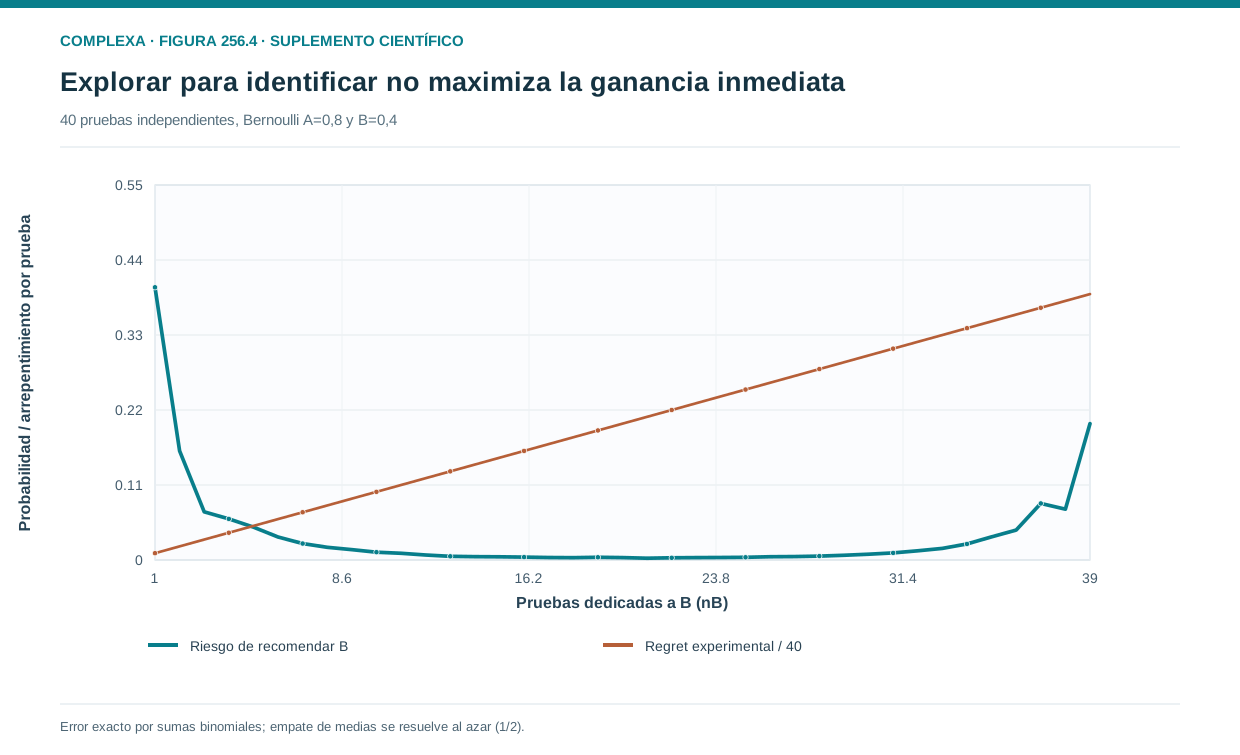
En algunas tareas interesa obtener la mayor recompensa durante el aprendizaje. En otras, se dispone de un presupuesto de experimentación y al final debe recomendarse una única opción. La primera situación favorece equilibrar recompensa e información en cada paso; la segunda puede justificar muchas pruebas de acciones que no conviene usar rutinariamente.
Supongamos dos procesos industriales con rendimiento desconocido. Si cada prueba produce también bienes vendibles, importa la recompensa obtenida durante la experimentación. Si las pruebas se hacen en un laboratorio y la decisión final afectará millones de operaciones, identificar correctamente el mejor proceso puede dominar el objetivo.
Una política que concentra pronto casi todas las observaciones en la opción aparentemente superior puede obtener buenas recompensas durante el aprendizaje, pero dejar incertidumbre sobre una alternativa cercana. Otra que reparta las muestras para reducir esa incertidumbre puede ser mejor para una recomendación final. Compararlas mediante una sola curva de recompensa sería incompleto.
Si una alternativa es claramente inferior, dedicarle muchas pruebas aporta poco a la decisión final. Si dos opciones son casi equivalentes, distinguirlas con alta confianza puede ser costoso y quizá innecesario si la pérdida por elegir cualquiera es pequeña.
Podemos declarar una tolerancia práctica y aceptar una opción cuyo valor esté suficientemente cerca del mejor. Esa formulación cambia el problema de identificación exacta y puede reducir el presupuesto necesario. La tolerancia debe fijarse según consecuencias relevantes y antes de ver qué resultado favorece al algoritmo.
Las restricciones también afectan la experimentación. Algunas acciones pueden ser irreversibles, consumir un recurso limitado o cerrar oportunidades. El bandido elemental supone que probar una opción no cambia su distribución ni impide futuras elecciones. Cuando este supuesto falla, la información debe valorarse junto con las transiciones que produce.
En decisiones secuenciales, explorar una ruta puede ser necesario para acceder a información que no aparece mediante variaciones locales de acción. Una política que cambia aleatoriamente una decisión de vez en cuando puede no alcanzar estados lejanos. La exploración debe considerar secuencias y estructura temporal.
La literatura sobre índices de asignación muestra que ciertas clases de problemas descontados admiten soluciones estructuradas bajo condiciones específicas [3]. La independencia entre procesos, su modo de evolución y el objetivo temporal determinan si puede usarse un índice. No existe una regla de exploración óptima para cualquier ambiente.
256.8. Explorar cuando el entorno cambia
Una opción poco atractiva puede mejorar mientras deja de observarse. Si el agente nunca vuelve a probarla, sus estimaciones quedan ancladas en datos que ya no describen el entorno. La exploración continua puede servir entonces para detectar cambios, además de para resolver la incertidumbre inicial.
Consideremos A con media 0,8 y B con media 0,4, que intercambian sus medias después de un tiempo. Un agente que aprendió correctamente y dejó de elegir B puede tardar en descubrir la inversión. Los peores resultados de A son evidencia de un cambio, pero sin probar B no indican qué alternativa mejoró.
Una política puede conservar una probabilidad mínima de prueba, usar ventanas recientes o descontar observaciones antiguas. Cada mecanismo introduce un compromiso. Olvidar rápido facilita seguir cambios, pero aumenta las fluctuaciones en periodos estables. Mantener toda la historia reduce el ruido, pero mezcla regímenes distintos.
El detector de cambio necesita una regla explícita. Reiniciar valores cuando el rendimiento cae por debajo de cierto umbral puede reaccionar a una ruptura o a una racha desfavorable. Debemos medir los falsos avisos, el retraso de detección y el costo de reaprendizaje. La adaptación se evalúa sobre distribuciones de escenarios, porque una sola inversión cuidadosamente elegida es insuficiente.
El referente para medir el desempeño también cambia. Comparar con una sola acción fija durante todo el horizonte responde a una pregunta distinta de comparar con un agente que conoce la mejor acción en cada momento. El segundo referente es más exigente y puede ser inalcanzable si los cambios son impredecibles y no hay observación inmediata.
La no estacionariedad no procede siempre del entorno externo. Otros aprendices modifican sus políticas y nuestras propias decisiones pueden alterar recursos o preferencias de usuarios; la distribución de recompensas puede depender entonces de la historia conjunta. En esos casos, un bandido estacionario es una aproximación cuyo alcance debe examinarse.
También puede haber cambios aparentes por selección de contextos. Si una opción se usa en situaciones más difíciles, su promedio observado puede caer aunque su funcionamiento condicional permanezca estable. Incorporar el contexto puede separar la modificación real de un cambio en la composición de los casos.
La exploración en ambientes cambiantes exige mantener abierta la posibilidad de revisar el conocimiento, aunque esa apertura tiene costos. El diseño debe justificar cuánto se vuelve a probar, qué señales activan la revisión y cómo se evita confundir la variación ordinaria con una transformación persistente.
256.9. Evaluar políticas de exploración
Una evaluación reproducible declara las distribuciones de recompensa, el horizonte, la información inicial y el costo de cada acción. También especifica si las acciones comparten información, si el entorno cambia y si existe un contexto observable. Sin estas condiciones, comparar nombres de algoritmos dice poco.
En un experimento sintético podemos generar una secuencia potencial de recompensas para cada acción y hacer que cada política consuma la siguiente observación de la acción elegida. Este acoplamiento permite comparaciones bajo una fuente común de variabilidad, siempre que preserve las distribuciones e independencias requeridas. No equivale a obligar a políticas distintas a recibir el mismo resultado en cada instante.
Debemos repetir realizaciones cuando el algoritmo o el entorno son aleatorios y presentar la incertidumbre de las métricas. Conviene registrar, además de la recompensa acumulada, las visitas por acción, los errores de identificación y el tiempo de adaptación después de cambios. Estas medidas permiten explicar por qué una política obtiene cierto resultado.
Los parámetros se ajustan en escenarios separados de la evaluación final. Elegir retrospectivamente el mejor valor de exploración para cada conjunto de prueba concede información adicional al procedimiento. Si un algoritmo conoce el horizonte o una cota de variación y otro no, esa diferencia debe informarse.
Las comparaciones también deben distinguir resultados ejecutados y cálculos analíticos. El ejemplo de la sección 256.2 puede resolverse exactamente sin simulación. Una curva obtenida al simular miles de episodios añade una comprobación de implementación, pero no convierte el modelo didáctico en evidencia sobre conducta real.
En UCB verificamos la inicialización y los denominadores de visitas; en Thompson, que éxitos y fracasos actualicen la posterior correcta; en épsilon-voraz, que la acción voraz también pueda seleccionarse durante el sorteo uniforme. Estos detalles cambian probabilidades y pueden explicar discrepancias entre implementaciones.
Finalmente, debemos comprobar que el agente no reciba medias verdaderas ni resultados de acciones no elegidas cuando la tarea no los permite. Esas cantidades solo pueden usarse para evaluar desde fuera; medir el aprendizaje exige mantener separadas la información del investigador y la del agente.
Una comprobación estadística sencilla puede usar un número de observaciones independientes de una acción fijado de antemano, con recompensas entre cero y uno. La desigualdad de Hoeffding acota la probabilidad de que la media empírica se aleje de la verdadera más de una tolerancia [4]. Para una tolerancia de 0,1 y probabilidad de error de 0,05, la cota habitual exige al menos 185 observaciones; reducir la tolerancia a 0,05 eleva ese número a 738. Estas cifras bastan según la cota, aunque el número realmente necesario puede ser menor.
Al reducir la tolerancia a la mitad, el término dominante cuadruplica las observaciones. Sin embargo, esa cota para una muestra de tamaño prefijado no debe aplicarse sin cambios a una regla que examina repetidamente los datos y se detiene cuando aparece el resultado deseado. El muestreo adaptativo y las consultas sucesivas requieren un control estadístico acorde con el procedimiento, porque un intervalo ordinario no es una garantía válida en cualquier instante.
Las conclusiones sobre una política deben limitarse a los ambientes y objetivos examinados. Las garantías teóricas las amplían cuando sus supuestos se cumplen; las simulaciones muestran el comportamiento en condiciones concretas. Ninguna de las dos sustituye automáticamente a la otra.
256.10. La información como consecuencia de una acción
Exploración y aprovechamiento expresan una tensión entre el beneficio inmediato y el conocimiento utilizable después. El equilibrio depende del horizonte, la incertidumbre, los costos y la estructura del entorno. La misma elección puede ser informativa y rentable, o novedosa sin aportar conocimiento útil.
El ejemplo exacto mostró que probar una opción de menor media puede aumentar la recompensa total cuando quedan decisiones futuras. Las políticas comparadas organizan esa búsqueda de maneras distintas, mediante aleatoriedad uniforme, bonificaciones de incertidumbre o muestreo de hipótesis. Cada mecanismo necesita supuestos y produce costos característicos.
Explorar no equivale a actuar irracionalmente; una elección aparentemente inferior puede tener valor informativo. Tampoco toda desviación de la mejor estimación merece interpretarse como exploración, porque puede reflejar un error, preferencias omitidas o información que el investigador no observó.
Los objetivos de experimentación deben mantenerse explícitos. Aprender para maximizar la recompensa durante el proceso, identificar una alternativa final y seguir un entorno cambiante son problemas distintos. Elegir una métrica adecuada evita declarar ganador a un procedimiento que resuelve una tarea diferente.
En agentes adaptativos, la política determina qué datos llegan a la regla de aprendizaje. Esa dependencia puede producir círculos de confirmación, en los que una opción evitada permanece desconocida y su desconocimiento sostiene la evitación. Romper ese círculo requiere experiencias que el procedimiento habitual quizá no genere.
El siguiente capítulo estudiará otra dificultad; aun cuando obtenemos una consecuencia, puede no estar claro qué decisión anterior merece crédito. Las recompensas diferidas conectan la exploración con la memoria y la representación temporal. Un agente debe descubrir acciones útiles y, además, relacionarlas con resultados que aparecen después.
Comprender cómo se seleccionan las experiencias prepara ese análisis. La información procede del entorno, pero también de las decisiones que el agente toma y de las oportunidades que esas decisiones mantienen abiertas.
Referencias
[1] Thompson, W. R. (1933). On the likelihood that one unknown probability exceeds another in view of the evidence of two samples. Biometrika, 25(3–4), 285–294. DOI.
[2] Auer, P., Cesa-Bianchi, N., y Fischer, P. (2002). Finite-time analysis of the multiarmed bandit problem. Machine Learning, 47, 235–256. DOI.
[3] Gittins, J. C. (1979). Bandit processes and dynamic allocation indices. Journal of the Royal Statistical Society: Series B, 41(2), 148–164. DOI.
[4] Hoeffding, W. (1963). Probability inequalities for sums of bounded random variables. Journal of the American Statistical Association, 58(301), 13–30. DOI.