Módulo 26. Agentes adaptativos y aprendizaje
258.1. Ver una señal no equivale a conocer el estado
Un agente puede recibir la misma observación en situaciones que requieren acciones diferentes. Una pantalla puede mostrar un indicador normal en dos condiciones internas distintas de una máquina. Un pasillo puede verse igual antes y después de activar un mecanismo. La información presente no siempre resume lo necesario para decidir.
La observación parcial distingue el estado del entorno de la señal disponible para el agente. El estado describe variables que determinan transiciones y consecuencias; la observación es una medición, posiblemente ruidosa o incompleta, de esas variables. Confundirlos concede al agente información que quizá no posee.
Los procesos de decisión de Markov parcialmente observables formalizan esta situación mediante estados ocultos, acciones, transiciones y probabilidades de observación. Los trabajos de Smallwood y Sondik y de Kaelbling, Littman y Cassandra establecen formulaciones y métodos de referencia para planificar en estos problemas [1,2].
La dificultad no desaparece con solo aumentar la cantidad de datos. Si dos estados producen siempre las mismas señales bajo todas las acciones disponibles, puede ser imposible distinguirlos. Si producen señales diferentes solo después de una acción de inspección, el agente debe decidir si conviene hacerla. La información depende de la estructura del sistema y de cómo se interactúa con él.
La memoria puede ayudar cuando observaciones anteriores contienen información relevante ausente del presente. Almacenar toda la historia tampoco garantiza usarla correctamente. Necesitamos una representación que combine evidencia, olvido y cambios del entorno según la tarea.
Con un ejemplo de dos estados ocultos y una señal imperfecta calcularemos creencias posteriores, decisiones y el valor de observar más; después introduciremos cambios del estado y veremos cuándo una memoria aprendida puede aproximar esa función.
La pregunta central será qué información necesita conservar el agente para que su decisión actual dependa de la historia pertinente. Esto conecta la observación parcial con el aprendizaje y la asignación de crédito, porque un resultado inesperado puede indicar una acción mal valorada, un estado mal inferido o un cambio del entorno.
258.2. Dos estados y una señal imperfecta
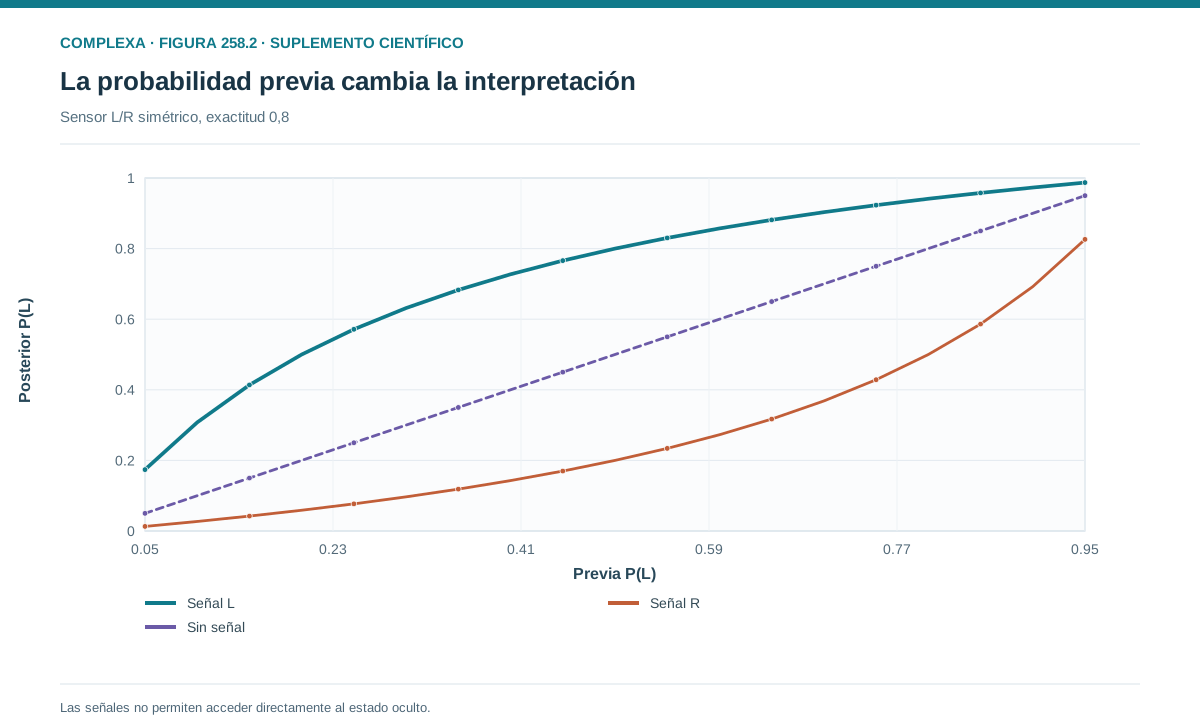
Supongamos que el entorno está en L o R, con probabilidades iniciales iguales. El estado permanece fijo durante el episodio. Una señal indica correctamente el estado con probabilidad 0,8 y se equivoca con probabilidad 0,2. Las señales repetidas son condicionalmente independientes dado el estado verdadero.
Después de observar una señal L, la probabilidad posterior de estar en L es 0,8. Por la regla de Bayes, basta comparar las verosimilitudes de la señal, 0,8 bajo L y 0,2 bajo R, porque ambas hipótesis tenían el mismo peso inicial. La señal no revela el estado con certeza.
Si observamos dos señales L consecutivas, las verosimilitudes son 0,64 bajo L y 0,04 bajo R. Al normalizar, la probabilidad de L es , aproximadamente 0,941. La repetición aumenta la confianza porque hemos supuesto independencia condicional.
Si observamos primero L y después R, ambas hipótesis producen esa secuencia con probabilidad 0,16 y la posterior vuelve a un medio. Cada observación es informativa, pero en este modelo simétrico sus contribuciones opuestas se compensan.
La independencia es decisiva. Si un sensor se queda bloqueado y repite su primera lectura, dos señales L no equivalen a dos mediciones independientes. Multiplicar probabilidades como si lo fueran produciría una confianza excesiva. El modelo de observación debe representar las dependencias relevantes.
También importa la probabilidad inicial. Si antes de medir L era muy improbable, una señal L con exactitud 0,8 puede no bastar para convertirlo en la hipótesis más probable. La fiabilidad del sensor y la probabilidad posterior de que una lectura sea correcta no coinciden en todos los contextos.
Podemos expresar las creencias mediante una sola cantidad ; la probabilidad de R es uno menos b. Esa representación comprime la historia para este modelo, pues dos secuencias distintas que producen la misma creencia permiten las mismas predicciones futuras, siempre que el estado sea fijo y las observaciones sigan el mecanismo declarado.
La compresión mantiene la incertidumbre en forma de distribución, sin seleccionar prematuramente una única etiqueta. Esa propiedad importa cuando las consecuencias de equivocarse sean asimétricas o cuando exista la opción de seguir observando.
258.3. Decidir con una distribución de creencias
Supongamos dos acciones finales, elegir L o elegir R. Acertar produce diez unidades y equivocarse, menos diez. Si la creencia de L es b, el valor esperado de elegir L es ; el de elegir R es . El agente elige la mayor de esas cantidades.
Con creencia inicial de un medio, ambas acciones tienen valor esperado cero. Después de una señal L, b es 0,8 y elegir L vale seis. Después de dos señales L, el valor es aproximadamente 8,824. La decisión usa la distribución de incertidumbre, aunque termine seleccionando una acción concreta.
La función de valor de la decisión final es . Tiene forma angular, porque la acción preferida cambia cuando b cruza un medio. Una variación pequeña de la creencia cerca de ese umbral puede cambiar la elección, mientras que una variación similar lejos de él puede no hacerlo.
Si los costos de error fueran distintos, el umbral se desplazaría. Un agente puede elegir una acción menos probable cuando el costo de equivocarse con la otra es mucho mayor, de modo que clasificar el estado más probable y actuar según él no siempre maximiza el objetivo.
Otra confusión consiste en calcular qué acción sería mejor si conociéramos el estado y luego promediar esos máximos. En nuestro ejemplo, un agente informado obtiene diez tanto en L como en R. Promediar da diez, pero el agente con creencia inicial igual no dispone de esa información y su mejor acción sin observar vale cero.
La diferencia es el valor potencial del conocimiento, porque elegir después de conocer el estado es una operación distinta de elegir antes. Intercambiar máximo y esperanza puede hacer que un modelo de observación parcial se comporte como si fuera completamente observable.
Una política sobre creencias asigna acciones a distribuciones sobre los estados ocultos. Puede decidir elegir L, elegir R o solicitar otra observación si esa acción está disponible. La planificación debe incluir cómo una observación futura modificará la creencia y, por tanto, la decisión posterior.
El ejemplo permite separar la incertidumbre del estado de la aleatoriedad de la política. Un agente puede tener creencias inciertas y elegir determinísticamente la acción de mayor valor. También puede aleatorizar por otras razones, pero la incertidumbre no obliga a sortear las acciones en proporción a las probabilidades del estado.
258.4. Memoria que conserva una señal desaparecida
Imaginemos que la señal aparece al comienzo del episodio y después desaparece, de modo que, al decidir, la pantalla muestra un símbolo neutro idéntico en L y R. Un agente que usa solo la observación actual no puede distinguir los dos estados; si son igualmente probables, su exactitud máxima con esa información es un medio.
Un agente que recuerda la señal inicial puede elegir según ella y alcanzar exactitud 0,8 bajo el modelo. La diferencia procede solo de conservar información a través del tiempo, ya que la observación presente es idéntica para ambos.
Esta tarea separa capacidad sensorial y memoria. Si un agente falla después de un retraso, puede haber olvidado la señal, representado mal la relación entre señal y estado o aplicado una política inadecuada. Si solo observamos el resultado, no sabemos qué componente falló.
Podemos variar el retraso manteniendo fija la fiabilidad del sensor, presentar señales contradictorias antes de la decisión o introducir distractores sin información. En esas condiciones, las predicciones de distintos mecanismos de memoria pueden divergir.
Una memoria mínima podría almacenar solo la última señal. Eso basta para usar una observación, pero pierde la evidencia acumulada cuando hay varias mediciones independientes. Otra memoria conserva un contador de señales L menos señales R; bajo supuestos simétricos y estado fijo, ese contador puede resumir la razón de verosimilitudes.
Si las señales tienen fiabilidades diferentes, contar sin ponderar deja de ser suficiente, porque la lectura de un sensor muy preciso debe pesar más que la de uno poco fiable. La representación adecuada depende tanto del modelo de observación como de la longitud de la historia.
También podemos conservar directamente la probabilidad posterior, que incorpora la evidencia en una variable continua. Para actualizarla correctamente hay que conocer o estimar las probabilidades del sensor. Una memoria numéricamente precisa sobre un modelo equivocado puede producir creencias sistemáticamente sesgadas.
En el modelo estático, cada señal L multiplica por cuatro la razón entre las probabilidades de L y R; cada señal R la divide por cuatro. Partiendo de probabilidades iguales, tres señales L y dos señales R dejan una razón de cuatro a uno y, por tanto, una posterior de 0,8. El orden no importa bajo independencia y estado fijo. El contador de la diferencia entre señales conserva exactamente la información que necesita esta actualización.
Este resultado permite comprobar una memoria aprendida presentando secuencias con el mismo número de señales de cada tipo y distinto orden. Si las respuestas del agente cambian, este usa algo más que el contador suficiente para el modelo estático (quizá recencia, posición o una expectativa de cambio). Esa diferencia puede ser un error respecto de la tarea declarada o una pista sobre el modelo interno del agente. Antes de interpretarla hay que verificar qué regularidades estuvieron presentes durante el entrenamiento.
Más que cuánta historia almacena el agente, interesa qué información conserva para predecir consecuencias y decidir. Una representación compacta puede ser suficiente en un problema y perder variables esenciales en otro, porque la suficiencia es siempre relativa a la tarea y a sus supuestos.
258.5. Cuando el estado oculto puede cambiar
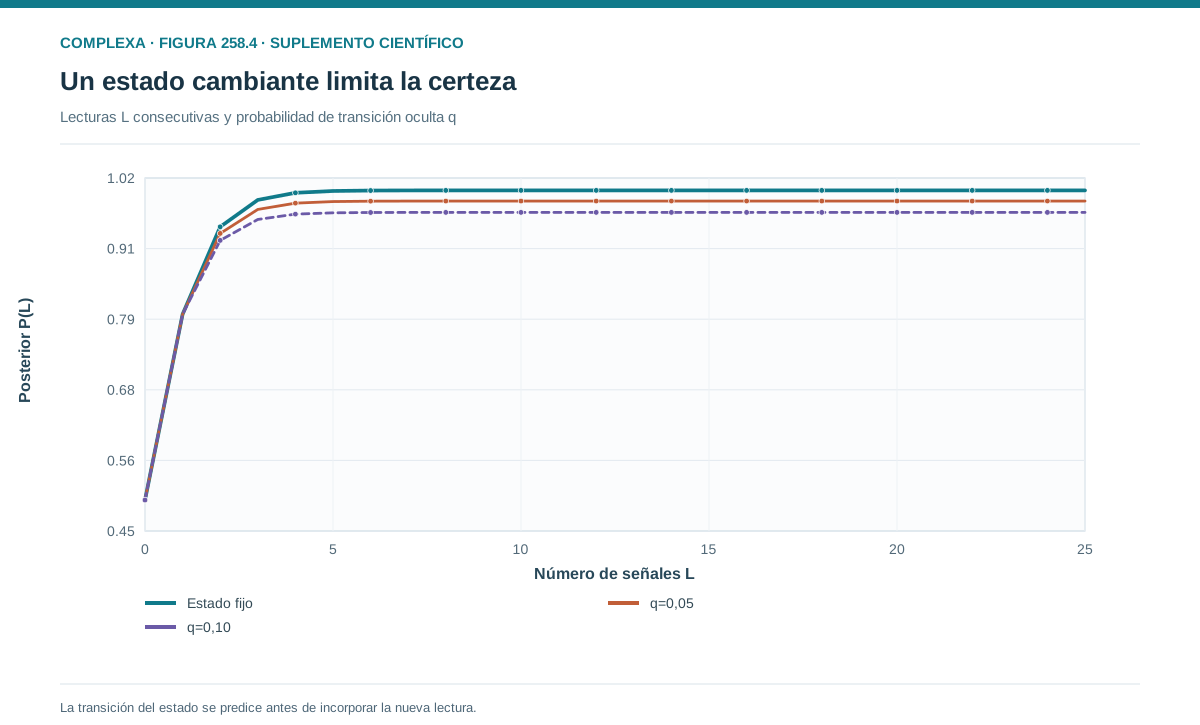
Supongamos ahora que el estado, fijo hasta aquí, cambia entre observaciones de L a R o de R a L con probabilidad 0,1. La evidencia antigua sigue siendo útil, pero su relevancia disminuye porque el estado puede haber cambiado. Para actualizar las creencias hay que predecir primero el estado actual y después incorporar la nueva señal.
Si la probabilidad posterior anterior de L era b, la predicción antes de observar es . Esta operación acerca la creencia a un medio; es un olvido justificado por la transición oculta especificada.
Después de una primera señal L, la creencia es 0,8. Antes de la siguiente observación, la predicción de L baja a 0,74. Si la segunda señal también es L, la actualización bayesiana produce , igual a , aproximadamente 0,919.
El resultado es menor que los 16/17 del estado fijo. Dos señales coincidentes sostienen una confianza alta, pero ahora es posible que el estado haya cambiado entre ellas. Aplicar la fórmula del caso estático sobreestimaría la certeza.
La actualización general de creencias, que combina transición y observación, es
La constante de normalización hace que las probabilidades sumen uno. Si la recompensa también informa sobre el estado, debe incorporarse entre las observaciones o en una probabilidad conjunta adecuada. Ignorar una consecuencia informativa desperdicia evidencia; contarla dos veces produce confianza excesiva.
Las acciones pueden modificar tanto el estado como la calidad de la observación. Inspeccionar una máquina puede revelar su condición sin cambiarla; repararla puede cambiarla y producir una señal. El modelo debe distinguir ambos efectos para actualizar correctamente las creencias.
Si no conocemos la probabilidad de cambio ni la fiabilidad del sensor, a la incertidumbre sobre el estado se suma la de los parámetros. Podemos estimarlos, pero sus efectos pueden confundirse, porque unas señales inconsistentes podrían indicar un entorno volátil o un sensor ruidoso. Diseñar observaciones que separen esas posibilidades es parte del problema.
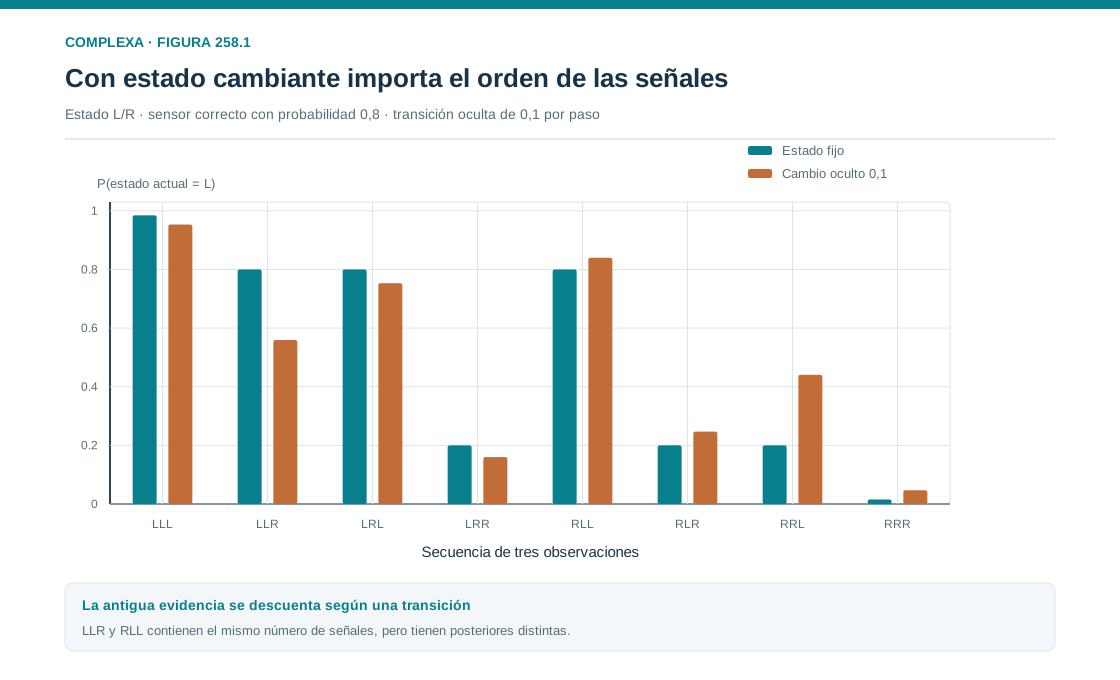
Ahora el orden de las señales sí puede importar. Con probabilidad inicial de un medio, fiabilidad 0,8 y probabilidad de cambio 0,1 entre mediciones, la secuencia L, L, R termina con probabilidad de L igual a 269/481, aproximadamente 0,559. La secuencia R, L, L termina con 404/481, aproximadamente 0,840. Ambas contienen dos señales L y una R, pero la evidencia reciente se refiere más directamente al estado actual.
Un contador que ignore el orden, suficiente en el modelo estático, daría ahora la misma respuesta a ambas secuencias y perdería información relevante. Una memoria debe evaluarse por lo que retiene y por cómo representa las transiciones del entorno; dar a las señales antiguas el mismo peso que a las recientes puede ser correcto o incorrecto según la dinámica.
Estos números son una prueba adicional del filtro. Deben calcularse alternando predicción del cambio y corrección por la señal, sin introducir una transición antes de la primera medición ni después de la última si preguntamos por el estado en ese instante. Desplazar el momento de la pregunta modifica la posterior pertinente y puede explicar aparentes discrepancias entre programas.
Una regla de memoria que descuenta la evidencia antigua puede aproximar ciertos filtros, pero su tasa de descuento no tiene, en general, una interpretación única. El mismo patrón de respuestas puede reflejar transición ambiental, ruido sensorial o una heurística de actualización.
258.6. El valor de observar otra vez
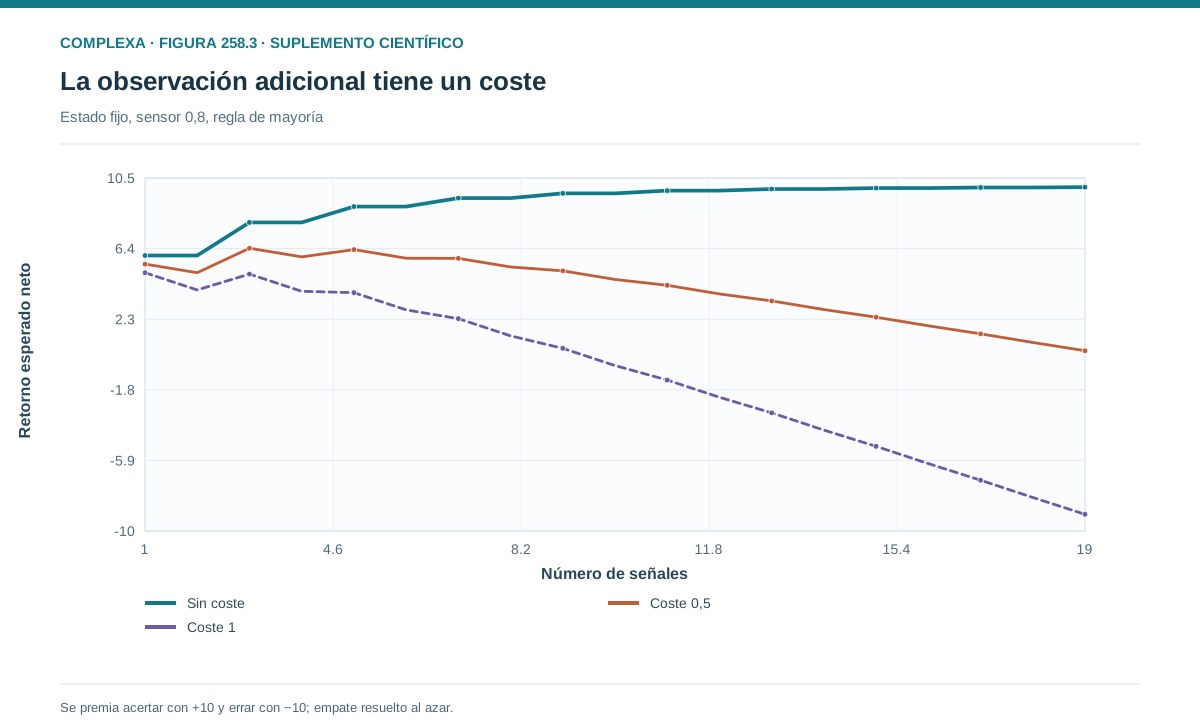
Una acción de observación puede tener valor aunque no produzca directamente el resultado final. Su utilidad depende de cuánto mejore la decisión posterior y de su costo. En el ejemplo inicial, sin señal, la mejor elección vale cero. Una señal de exactitud 0,8 permite acertar con esa probabilidad y da un valor esperado de seis antes de costos.
Si observar cuesta dos unidades, el valor neto es cuatro y conviene hacerlo cuando existe una sola oportunidad de inspección antes de decidir. Si cuesta siete, el valor neto es negativo bajo el objetivo declarado. El costo debe incluir cualquier demora o recurso relevante.
El valor de una observación adicional no es constante. Después de una señal L, la creencia es 0,8; una segunda señal puede confirmarla o contradecirla. En el caso simétrico de estado fijo, usar dos señales con desempate aleatorio mantiene una exactitud promedio de 0,8, ya que, cuando discrepan, no sabemos cuál fue la correcta.
Por tanto, una única observación adicional no mejora el valor esperado de la decisión en ese punto, aunque cambie la distribución de creencias. Puede aumentar la confianza o devolverla a un medio, pero esas modificaciones se compensan en el promedio del objetivo final. Información estadística y utilidad decisional no son idénticas.
Podemos verificar la compensación condicionando a la primera señal L. La probabilidad de que la siguiente también sea L es 0,68, porque combina un estado L probable y una lectura correcta con un estado R menos probable y una lectura errónea; en ese caso, la posterior alcanza dieciséis diecisieteavos. La probabilidad de recibir R es 0,32 y la posterior queda en un medio. La exactitud esperada de la mejor elección posterior es 0,68 multiplicado por dieciséis diecisieteavos más 0,32 multiplicado por un medio, exactamente 0,8.
Si solo miráramos los episodios donde la segunda señal confirma la primera, concluiríamos que consultar siempre mejora mucho la decisión. Una evaluación prospectiva, sin embargo, debe incluir también las señales contradictorias y sus probabilidades. Seleccionar retrospectivamente las consultas exitosas produce una estimación sesgada del valor de la información.
Si permitimos dos señales adicionales, tres en total, la mayoría identifica el estado correctamente con probabilidad . El valor esperado pasa de seis a 7,92. La mejora es 1,92 antes del costo de las dos observaciones nuevas.
Con un costo de medio punto por observación, adquirir ambas da una mejora neta de 0,92. Una regla que evalúa solo el beneficio de una observación y se detiene si ese beneficio inmediato es nulo puede perder esta oportunidad. La planificación sobre información puede tener que considerar secuencias de consultas.
Estas cifras dependen de independencia condicional, costos constantes y estado fijo. Si el estado cambia mientras observamos, las señales antiguas pueden dejar de referirse al estado actual. Si medir altera el sistema, el cálculo debe incluir esa transición. Más observaciones no garantizan una decisión mejor con cualquier procedimiento.
El ejemplo muestra por qué observar es una acción dentro del problema de control. El agente debe anticipar las posibles señales, las creencias posteriores y las decisiones que esas creencias permitirán. La incertidumbre se convierte así en una variable que puede modificarse deliberadamente.
258.7. Creencias como estado suficiente
Con un modelo conocido de transición y observación, la distribución posterior sobre estados ocultos puede usarse como estado informativo suficiente para planificar. Resume la historia necesaria para predecir observaciones y recompensas futuras bajo cada acción. El problema parcialmente observable puede reformularse así como uno sobre creencias [1,2].
Esta reformulación no elimina la dificultad computacional. Aunque el conjunto de estados ocultos sea finito, las creencias forman un espacio continuo. Con dos estados basta una probabilidad; con muchos, necesitamos un vector sujeto a normalización. Planificar sobre ese espacio puede resultar costoso.
Una creencia suficiente para un modelo tampoco lo es necesariamente si el modelo cambia o si omitimos parámetros desconocidos. Si la fiabilidad del sensor también se aprende, quizá debamos conservar una distribución conjunta sobre estado y parámetros. Reducirla a una probabilidad de L puede perder información relevante para futuras consultas.
Para un investigador que estudia un organismo, el estado de creencias no es directamente observable; es una construcción del modelo. Inferir que el agente mantiene una posterior exacta requiere evidencia que la distinga de aproximaciones, reglas de conteo o memorias limitadas.
Podemos comparar políticas que usan distintas representaciones (observación actual, última señal, contador de señales o posterior completa). En tareas bien diseñadas, sus decisiones divergen. Una representación más completa puede mejorar el desempeño, pero también exigir más recursos o parámetros de aprendizaje.
La exactitud predictiva permite otra evaluación. Si el agente informa probabilidades, podemos examinar su calibración, es decir, si, entre las ocasiones con creencia cercana a 0,8, L ocurre aproximadamente en esa proporción. La calibración no garantiza una política óptima, pero ayuda a separar la calidad de la inferencia de la calidad de la decisión.
Una creencia muy segura no demuestra un conocimiento correcto. Un modelo que supone sensores independientes cuando comparten errores puede concentrar indebidamente la creencia. La incertidumbre representada debe evaluarse frente al mecanismo que genera los datos, además de por su coherencia interna.
La suficiencia define un objetivo conceptual (conservar lo necesario para predecir y actuar) que las implementaciones prácticas pueden aproximar. Declarar qué información se descarta permite estudiar cuándo esa aproximación funciona y qué cambios de tarea la hacen fallar.
258.8. Memorias aprendidas y redes recurrentes
En problemas grandes, donde escribir un filtro exacto puede ser difícil, se puede aprender una representación interna de la historia. Una red recurrente actualiza un estado interno a partir de la observación, la acción previa y la memoria anterior; después usa ese estado para predecir valores o seleccionar acciones.
Hausknecht y Stone estudiaron una red Q recurrente que integra información a través del tiempo en tareas parcialmente observadas [3]. El trabajo ilustra una arquitectura posible; nada garantiza que cualquier recurrencia recupere el estado verdadero o resuelva cualquier proceso parcialmente observable.
El estado interno de una red no es necesariamente una distribución de probabilidades interpretable. Puede conservar rasgos útiles para la tarea sin representar explícitamente L y R. Para comprender qué aprende, podemos comprobar si permite predecir variables relevantes y cómo responde a intervenciones sobre la historia.
La recurrencia obliga a declarar cómo se inicializa la memoria, cuándo se reinicia, qué longitud de secuencia se usa para aprender y cómo se manejan los fragmentos de episodios. Entrenar con la memoria reiniciada constantemente puede impedir aprender dependencias largas aunque la arquitectura permita representarlas.
También hay una diferencia entre capacidad y adquisición. Una red puede ser lo bastante expresiva para almacenar una señal durante muchos pasos y, aun así, no aprender a hacerlo con los datos y el algoritmo usados.
La generalización temporal requiere una evaluación específica. Un agente entrenado con retrasos de cinco pasos puede fallar con retrasos de veinte. Otro puede acertar gracias a una regularidad accidental del tiempo sin recordar la señal. Variar retrasos y distractores ayuda a distinguir la memoria pertinente de los atajos.
Conviene comparar con soluciones simples. En el ejemplo binario, guardar una posterior o un contador es transparente y barato. Una red compleja no hace falta para resolverlo, aunque estudiarla permite comprobar si aprende una estrategia equivalente. El referente exacto permite interpretar sus errores.
La evaluación debe incluir condiciones donde la memoria y la observación actual entren en conflicto. Si el agente ignora siempre la historia cuando aparece una señal llamativa, quizá no combine la evidencia como se esperaba. Si se aferra a la historia ante un cambio real, puede conservar información demasiado tiempo.
258.9. Diseñar pruebas de observación parcial
Un experimento debe especificar el estado oculto, las observaciones y las acciones accesibles. El investigador puede conocer el estado para generar datos y evaluar, pero esa variable no debe entrar accidentalmente en la política. Filtrar el estado verdadero durante el entrenamiento o la evaluación puede hacer que un agente parezca resolver un problema más difícil del que realmente enfrenta.
En nuestro ejemplo, una prueba inicial compara la exactitud sin señal, con una señal y con tres señales independientes. Los valores de referencia son 0,5; 0,8 y 0,896 cuando se elige por la evidencia apropiada. Las simulaciones deben aproximarlos dentro de la variabilidad muestral, sin exigir coincidencia exacta en una realización finita.
Una prueba de actualización verifica las posteriores de dos señales iguales y de dos opuestas. Otra incorpora la transición oculta y comprueba la secuencia predicción–corrección. Invertir ese orden puede tratar una observación como si perteneciera a otro instante y alterar la creencia.
También debemos examinar casos imposibles bajo el modelo. Si una observación tiene probabilidad cero en todos los estados, la normalización falla. La implementación necesita un tratamiento declarado, como revisar el modelo, introducir una probabilidad de contaminación o informar la inconsistencia. Sustituir silenciosamente una posterior arbitraria oculta un problema científico.
Para estudiar la memoria, presentamos una señal inicial seguida de observaciones neutras y variamos la duración, la interferencia y los cambios reales del estado. El agente debe recordar cuando la información sigue vigente y revisarla cuando deja de serlo. Una única prueba de retención no evalúa ambas capacidades.
Las comparaciones entre representaciones deben usar información equivalente. Si un agente recibe la historia completa y otro solo la observación actual, la diferencia mide el acceso a la información además del algoritmo. Esa comparación puede ser intencional, pero debe describirse correctamente.
En datos empíricos, ajustar un filtro exacto no demuestra que la persona lo ejecute. Podemos comparar predicciones de elección, confianza y respuesta a señales de fiabilidad variable. Que un modelo explique una medida y prediga otra ayuda a restringir las interpretaciones.
Debemos separar la incertidumbre del agente sobre los estados de la incertidumbre del investigador sobre los parámetros. Ambas pueden aparecer juntas, pero tienen objetos distintos. Un intervalo de ajuste amplio sobre una tasa no equivale a una creencia incierta del agente sobre dónde se encuentra.
258.10. Aprender a representar lo que no se observa
La observación parcial distingue entre estado, señal y creencia. El agente decide con información que puede ser incompleta, ruidosa y temporalmente distribuida. La memoria es útil cuando conserva evidencia pertinente, pero debe combinarse con un modelo o una regla que determine cómo cambia el significado de esa evidencia.
El ejemplo binario permitió calcular posteriores y decisiones sin ambigüedad. Las señales repetidas aumentaron la confianza bajo independencia; las opuestas se compensaron; los cambios ocultos redujeron la vigencia de la información antigua. Cada resultado dependió de supuestos que una implementación debe declarar.
Observar también puede tener valor como acción. Sin embargo, una señal adicional puede reducir la incertidumbre sin mejorar de inmediato la decisión; en cambio, una secuencia de señales puede tener un valor que una evaluación miope no detecta. La planificación informativa requiere considerar cómo el conocimiento modifica las opciones futuras.
Las creencias son una representación suficiente cuando el modelo es conocido, aunque su espacio puede ser complejo. Las memorias aprendidas son aproximaciones cuya calidad hay que evaluar. Ni una posterior exacta sobre un modelo erróneo ni una red recurrente expresiva garantizan buenas decisiones.
Estas distinciones ayudan a interpretar errores de aprendizaje. Una conducta persistente puede reflejar un valor desactualizado, una inferencia equivocada del estado o una memoria que conserva el contexto anterior. Modificar una tasa de actualización no resuelve necesariamente un problema de representación.
El capítulo siguiente examinará la plasticidad y la estabilidad, es decir, cuánto cambiar después de una experiencia y cómo evitar que la adaptación destruya regularidades útiles. Esa pregunta debe plantearse sobre una representación adecuada. Si el agente mezcla estados distintos, aumentar su flexibilidad puede acelerar el aprendizaje de una confusión.
Comprender lo que el agente observa y recuerda permite situar cada actualización en su contexto informativo. Así, la adaptación queda definida como un proceso sobre señales, memorias, creencias y decisiones.
Referencias
[1] Smallwood, R. D., y Sondik, E. J. (1973). The optimal control of partially observable Markov processes over a finite horizon. Operations Research, 21(5), 1071–1088. DOI.
[2] Kaelbling, L. P., Littman, M. L., y Cassandra, A. R. (1998). Planning and acting in partially observable stochastic domains. Artificial Intelligence, 101(1–2), 99–134. DOI.
[3] Hausknecht, M., y Stone, P. (2015). Deep recurrent Q-learning for partially observable MDPs. AAAI Fall Symposium on Sequential Decision Making for Intelligent Agents. Prepublicación de los autores.