COMPLEXA · Ciencias de la Complejidad y Teoría del Caos
Módulo 17. Renormalización, universalidad y descripción multiescala
170.1. Planteamiento del sistema de N=100 unidades binarias independientes
Consideramos unidades binarias independientes, cada una inactiva (0) o activa (1), con transiciones aleatorias en tiempo continuo. El objetivo es derivar de esta dinámica local la evolución del indicador colectivo y sus propiedades. Indicaremos en cada caso qué resultados dependen de la homogeneidad y de la preparación inicial.
Sea el estado de la unidad en el instante . Cada unidad sigue una cadena de Markov de dos estados; dado el estado presente, su evolución futura no depende adicionalmente de su historia. Las tasas constantes, con dimensiones de inverso de tiempo, son
En un intervalo breve , las probabilidades de activación y desactivación son, respectivamente, y . Las unidades comparten las mismas tasas y sus mecanismos de transición son independientes; esto no exige que los estados iniciales sean independientes. Podemos partir de una configuración fija o de estados iniciales independientes o correlacionados; la elección afecta a algunas distribuciones transitorias.
El indicador global es el número de unidades activas y su versión normalizada es la fracción de actividad
El espacio microscópico contiene todas las configuraciones binarias, mientras que toma valores de cero a cien. Comprobar que sus transiciones se describen sin conocer la configuración completa es el paso de agregación de cadenas de Markov (Buchholz, 1994). El modelo es didáctico y sus resultados numéricos se calculan analíticamente a partir de las ecuaciones especificadas; la simulación estocástica exacta es una posible vía de validación (Gillespie, 1977).
170.2. La ecuación local y su solución explícita
Sea la probabilidad de actividad de una unidad. Durante un intervalo breve, la actividad aumenta por transiciones desde el estado inactivo y disminuye por transiciones desde el estado activo. Al dividir el balance probabilístico por la duración del intervalo y tomar el límite, obtenemos una ecuación diferencial lineal que conserva la normalización de las probabilidades.
El equilibrio se obtiene al anular la derivada. Para los parámetros elegidos, la probabilidad estacionaria es y la tasa de relajación es . El equilibrio expresa la compensación entre flujos probabilísticos opuestos; su valor depende de la proporción entre tasas, mientras que la rapidez de aproximación depende de su suma.
La solución se obtiene multiplicando la ecuación por el factor integrante , con lo que el miembro izquierdo pasa a ser la derivada de un producto. Integrando desde cero hasta con condición inicial , donde es una probabilidad y debe pertenecer al intervalo unidad, resulta
La diferencia respecto del equilibrio conserva su signo y disminuye exponencialmente. Por tanto, la aproximación es monótona para cualquier preparación individual. El tiempo característico indica cuánto tarda esa diferencia en reducirse por un factor . No es un instante de llegada exacta al equilibrio, que solo se alcanza como límite temporal.
Para describir preparaciones deterministas conviene introducir , donde el primer índice corresponde al estado inicial. Sustituir sucesivamente y da las dos probabilidades de terminar activo. En las expresiones numéricas siguientes, el tiempo se mide en segundos.
Las otras entradas de la matriz de transición son sus complementos, y , de modo que cada fila suma uno. En tiempo cero recuperamos la matriz identidad y a tiempos largos ambas filas convergen a la distribución estacionaria. La diferencia mide la memoria del estado inicial.
Estas probabilidades condicionales se usarán al agregar unidades preparadas de formas distintas. La igualdad de tasas garantiza un mismo operador de evolución, aunque las probabilidades de actividad pueden ser distintas cuando los estados iniciales difieren. Conservar esa distinción evita atribuir una ley binomial común a preparaciones que mantienen dos grupos con probabilidades diferentes.
170.3. Agregación en la cadena de nacimiento y muerte del número de activos
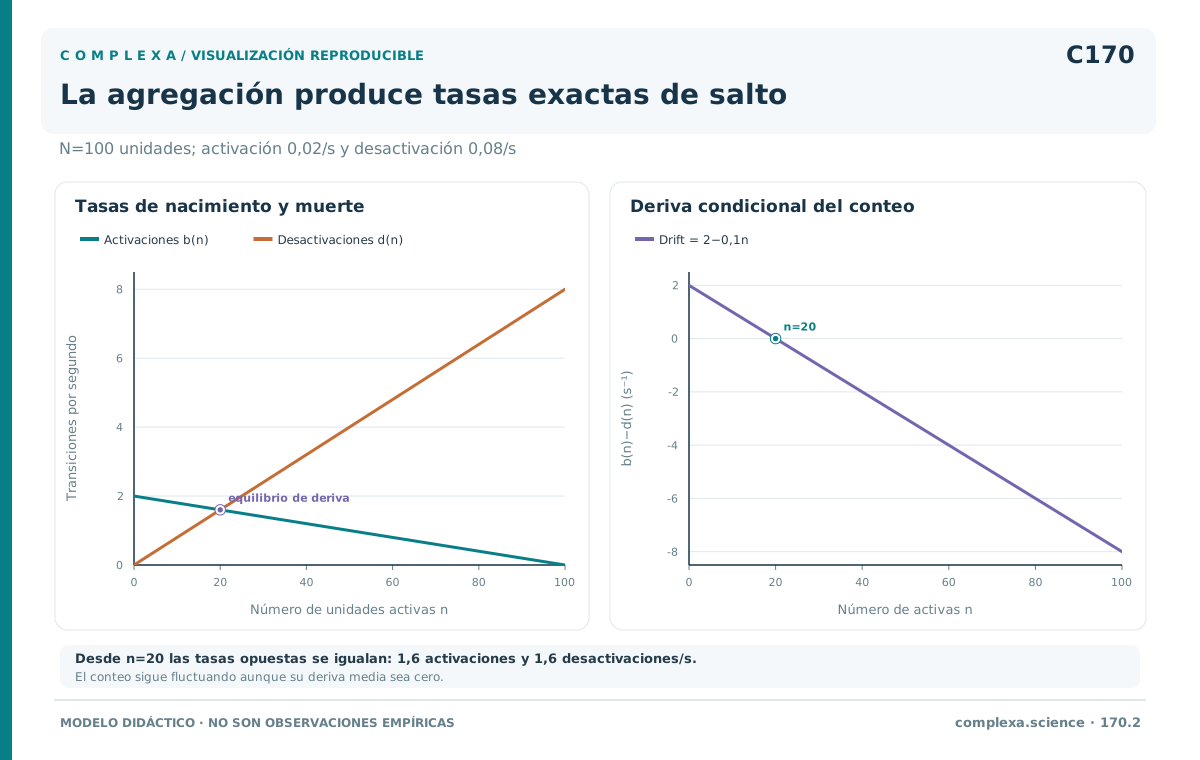
Cuando el indicador vale , hay unidades inactivas y activas. Cada unidad inactiva puede producir un incremento del total y cada unidad activa, un decremento. La independencia de los mecanismos permite sumar las tasas individuales. La homogeneidad garantiza que el resultado depende únicamente del número de unidades disponibles en cada estado.
Por ello, es una cadena de nacimiento y muerte sobre . Sus saltos tienen amplitud uno, porque la probabilidad de saltos simultáneos es despreciable al orden temporal que define el generador. En el extremo cero solo son posibles nacimientos; en el extremo , solo muertes. Estas restricciones impiden abandonar el espacio de estados físicamente permitido.
La reducción es exactamente markoviana porque todas las configuraciones con igual número de activos tienen la misma tasa total hacia cada bloque de destino. Esta propiedad se denomina lumpability y es una condición de agregación exacta (Buchholz, 1994). El criterio se formula sobre el generador microscópico y permite usar el proceso agregado con cualquier distribución inicial compatible con el modelo.
Definamos . Su variación reúne entradas desde los estados vecinos y salidas desde el propio estado. Con la notación y , la ecuación maestra adopta la forma compacta
Explícitamente, el primer término de entrada es y el segundo es . El término de salida contiene . Los términos con índices inexistentes se anulan; además, y . Esta convención permite usar la misma expresión en todo el intervalo sin introducir probabilidades fuera del dominio.
La conservación de probabilidad se comprueba sumando la ecuación sobre todos los estados. Cada flujo que sale de un estado aparece como entrada en su vecino y, gracias a las condiciones de frontera, no quedan flujos residuales. Por tanto, una distribución inicialmente normalizada conserva su suma igual a uno. La positividad se hereda de que las tasas de transición son no negativas.
La exactitud de la agregación se refiere a la evolución del indicador. Las identidades individuales y las configuraciones concretas dejan de estar disponibles después de agregar, pero toda predicción probabilística sobre el número de activos puede obtenerse desde esta cadena reducida. Más adelante, las tasas heterogéneas mostrarán que conservar el espacio de valores del indicador no garantiza una dinámica autónoma sobre él.
170.4. Ecuación exacta de la media del indicador y solución desde n0=60
Como los saltos asociados a las tasas y son y , la deriva en un estado con activos es
Al tomar esperanza, la linealidad de la deriva cierra exactamente la ecuación de la media, sin momentos superiores. Con y , la ecuación y su solución son
Este resultado también se obtiene sumando las medias de las unidades, , de modo que vale incluso si los estados iniciales de las unidades dependen entre sí; la dinámica local es independiente y no hace falta factorizar productos entre estados.
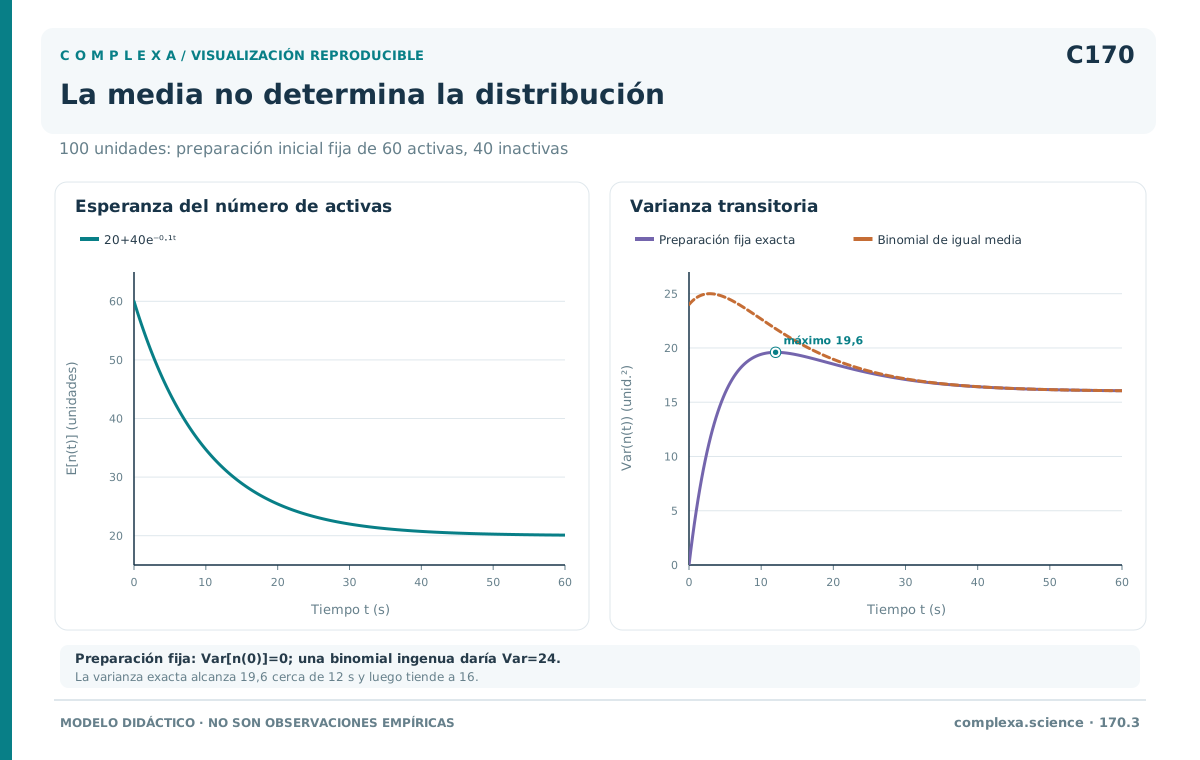
Con exactamente sesenta unidades activas al inicio, . La media estacionaria es , por lo que el exceso inicial es y
Con en segundos, y . Estos promedios pueden ser fraccionarios aunque cada observación sea entera, porque la curva media no es una trayectoria individual. La fracción activa satisface y conserva el tiempo de relajación. Preparaciones con igual media inicial comparten esta evolución media, aunque sus distribuciones sean diferentes.
170.5. La distribución estacionaria binomial
En equilibrio, cada unidad tiene probabilidad de actividad y la distribución estacionaria conjunta es el producto de las distribuciones Bernoulli individuales. Como el indicador suma cien variables binarias independientes con idéntica probabilidad, su distribución estacionaria es binomial. Denotaremos por la probabilidad de encontrar exactamente unidades activas bajo esa distribución, independientemente de cómo se haya preparado inicialmente el sistema.
El coeficiente combinatorio cuenta las configuraciones microscópicas con el mismo número de activos. Todas esas configuraciones tienen igual probabilidad estacionaria porque las unidades son homogéneas. La suma de las probabilidades sobre todos los valores de vale uno por el teorema binomial.
Podemos verificar el resultado sin recurrir a la descripción microscópica. El balance detallado exige que el flujo estacionario entre cada par de estados vecinos sea igual en ambas direcciones. Para la cadena de nacimiento y muerte, la condición es
En efecto, el cociente entre probabilidades consecutivas de la binomial es ; la igualdad lo transforma en la relación requerida. Como todas las tasas interiores son positivas, la cadena finita es irreducible y su distribución estacionaria es única. El balance por pares también garantiza que la ecuación maestra se anula en equilibrio.
Los momentos estacionarios se calculan sumando los de las variables Bernoulli. La media es veinte, la varianza es dieciséis y la desviación típica, su raíz cuadrada, vale cuatro. Estos valores fijan la escala de las fluctuaciones instantáneas alrededor del promedio colectivo y permiten contrastar cualquier cálculo numérico posterior con una predicción analítica exacta.
Una distribución de Poisson con media veinte tendría varianza veinte, de modo que no coincide con la estacionaria del caso estudiado. La diferencia se debe a la restricción binaria y al tamaño finito de la población. La aproximación de Poisson corresponde a un régimen de probabilidad individual pequeña y población grande, en el que suele mantenerse fijo el producto que determina el número medio de activos.
La distribución binomial describe observaciones tomadas en un instante de equilibrio y deja sin especificar su orden temporal. Distintas elecciones de tasas pueden conservar y, en consecuencia, esta misma distribución. Para discriminar entre esas dinámicas hay que observar la relajación o la autocovarianza.
170.6. La distribución transitoria desde 60 activos
Una configuración inicial con sesenta unidades activas y cuarenta inactivas define dos grupos con probabilidades transitorias distintas. Las unidades inicialmente activas permanecen o vuelven a estar activas con probabilidad ; las inicialmente inactivas se encuentran activas con probabilidad . La independencia de las transiciones se conserva, aunque la preparación fija impide asignar la misma probabilidad a todas las unidades durante el transitorio.
Sea el número de activos del primer grupo y el del segundo. Para una configuración inicial especificada, ambas variables son independientes y tienen distribución binomial, con tamaño igual al número de integrantes de su grupo. El total y las probabilidades correspondientes quedan descritos por
La distribución del total es la convolución de esas dos leyes. Para un valor entero admisible , se suman los productos sobre los índices que respetan los tamaños de ambos grupos, . Esta descripción es exacta y permite calcular cualquier probabilidad transitoria sin resolver numéricamente toda la ecuación maestra.
Los primeros momentos son sencillos. La esperanza es , que reproduce . La varianza se obtiene sumando las varianzas de los grupos independientes. Cada término depende de su propia probabilidad, por lo que sustituir ambas por una probabilidad promedio alteraría la dispersión del indicador.
En el instante inicial, y , de modo que la varianza es cero (el total inicial se conoce exactamente). A tiempos largos, ambas probabilidades convergen a y la varianza tiende a dieciséis. La convolución converge entonces a la binomial estacionaria con cien ensayos y la diferencia entre grupos desaparece con la escala de relajación local.
La ley transitoria sería si los estados iniciales fueran independientes e idénticamente distribuidos con probabilidad . En ese caso cada unidad comparte desde el principio la misma marginal y la evolución independiente mantiene la estructura producto. Una preparación con total fijo introduce una restricción distinta, incluso cuando se aleatoriza qué unidades pertenecen al conjunto inicialmente activo.
Elegir al azar una unidad del conjunto da una probabilidad promedio de actividad igual a . Esa marginal promedio no implica que los cien estados sean ensayos independientes con una probabilidad común. Para determinar la distribución de la suma hay que conservar la información sobre la preparación y las dependencias relevantes, además de la media individual promediada.
La preparación con sesenta unidades activas admite una comprobación adicional de la varianza transitoria. Escribamos el factor de relajación como una sola variable temporal. Al sustituir las dos probabilidades condicionales en la suma de varianzas binomiales y desarrollar los productos, resulta
En el instante inicial la expresión vale cero porque se conoce exactamente el total activo; a tiempos largos recupera dieciséis. Entre ambos extremos puede superar el valor estacionario; aquí el máximo ocurre cuando el factor exponencial vale tres décimas, a los segundos, con una varianza de . Así, la dispersión no tiene por qué acercarse monótonamente a su límite, aunque la media sí lo haga en este ejemplo.
A los diez segundos, las probabilidades de actividad de los dos grupos iniciales son aproximadamente y . La varianza total es aproximadamente , frente a una media cercana a . Una binomial construida con esa media y cien ensayos daría otra varianza. El desacuerdo surge de la preparación inicial y de las probabilidades diferentes que todavía conservan los grupos, sin que intervenga interacción alguna entre unidades.
La distribución predictiva completa permite también preguntar por umbrales. La probabilidad de superar cierto número de activos se obtiene sumando la convolución de las dos binomiales por encima del umbral. Para calcularla con estabilidad numérica conviene usar probabilidades binomiales normalizadas o recurrencias, que evitan factoriales enormes. La aproximación normal puede servir en la región central, pero debe contrastarse si interesa una cola pequeña o un tiempo cercano al inicio, cuando la distribución puede ser estrecha y asimétrica.
Las preparaciones aleatorias añaden otra contribución calculable. Si el número inicial de activos es incierto, la ley de la varianza total separa la dispersión promedio condicionada a ese número de la dispersión entre medias condicionales. Esta última contribución decae con el cuadrado del factor exponencial de relajación. Conocer solo la media inicial deja indeterminada la varianza posterior mientras no se especifique aquella incertidumbre. Si y , la fórmula exacta es
En un experimento con activación parcial, registrar el conteo inicial de cada repetición permite condicionar las predicciones y evita atribuir al ruido dinámico diferencias que ya existían antes de empezar la observación.
170.7. Autocovarianza estacionaria y muestreo
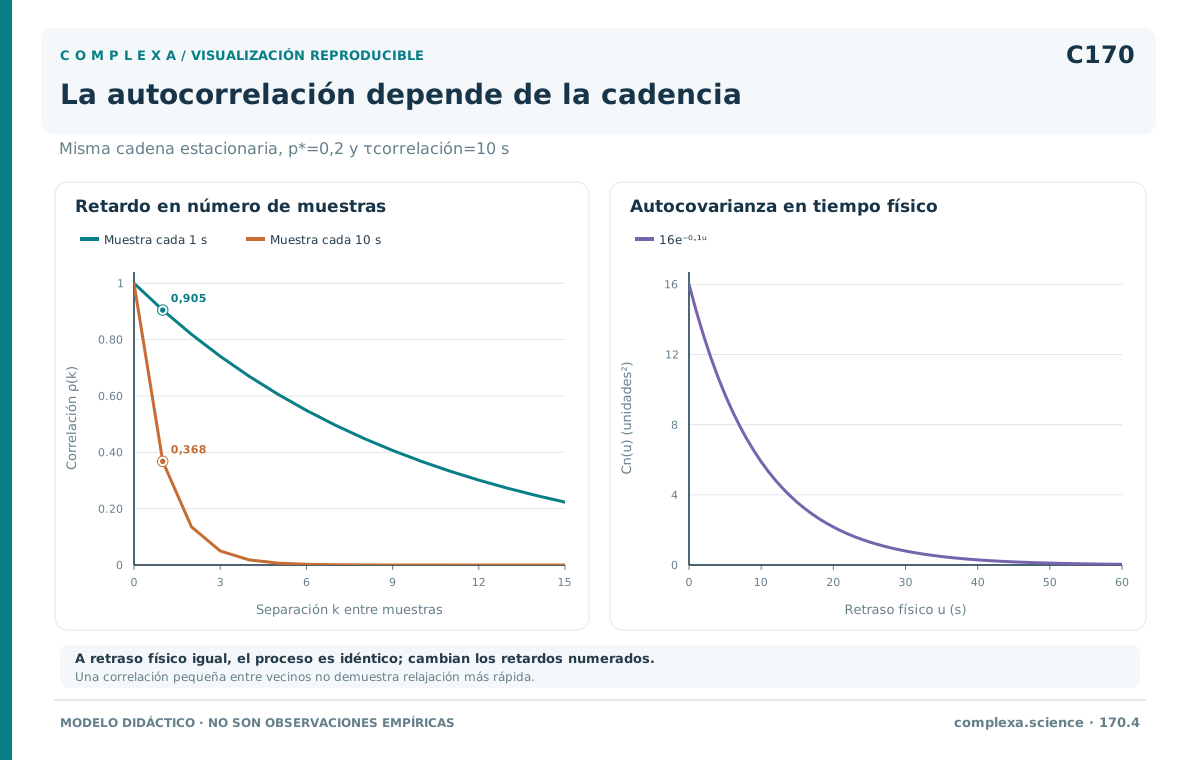
En régimen estacionario, la correlación temporal de una unidad se deriva de su esperanza condicional. Para un retardo positivo , la desviación esperada respecto del equilibrio, condicionada al estado inicial, es . Al multiplicarla por la desviación inicial y tomar esperanza, la autocovarianza queda expresada mediante la varianza Bernoulli y la tasa de relajación local.
Las covarianzas cruzadas entre unidades diferentes se anulan bajo la distribución estacionaria producto, de modo que la autocovarianza del total es la suma de cien contribuciones idénticas. Denotaremos esa función por , donde es el retardo, medido en segundos. La simetría de la covarianza de un observable escalar estacionario justifica escribir el valor absoluto del retardo.
En retardo cero recuperamos las varianzas instantáneas, dieciséis para el número de activos y para la fracción. La covarianza del conteo se expresa en unidades de al cuadrado, mientras que la correlación normalizada, que se obtiene dividiendo por la varianza, es adimensional. Normalizar el indicador modifica la amplitud de su covarianza, pero deja intacta su función de correlación temporal.
Si se registran observaciones separadas por un intervalo , la correlación entre muestras sucesivas es . Muestrear cada segundo da , mientras que muestrear cada diez segundos da . La segunda separación reduce la dependencia entre vecinos, aunque ninguna de estas correlaciones equivale a independencia exacta.
La dependencia temporal determina el error de una media estimada a partir de una trayectoria. Definamos la media temporal continua , con duración de observación . Si la trayectoria empieza en equilibrio, su esperanza es veinte. La varianza del estimador depende de toda la autocovarianza a través de una integral ponderada por el número de pares temporales disponibles a cada retardo.
Para duraciones mucho mayores que diez segundos, la expresión se aproxima a ; la desviación típica del estimador es su raíz. Para la media temporal de la fracción, la varianza se divide por diez mil. La amplitud del error disminuye con la duración, pero su prefactor depende de la persistencia temporal del sistema.
Aumentar la frecuencia de registro dentro de una ventana fija añade observaciones muy redundantes cuando la separación es pequeña respecto de la relajación. La precisión de la media temporal no depende solo del número de registros; el análisis debe conservar la duración observada, el intervalo de muestreo y la estructura de correlaciones inducida por las tasas locales.
La observación a intervalos discretos introduce una segunda distinción. Una unidad puede cambiar dos veces entre registros y regresar al mismo estado, de modo que contar solo los cambios visibles y dividir por el intervalo subestima la actividad real. Para la unidad homogénea, las probabilidades entre dos registros separados por un tiempo conocido son las probabilidades de transición ya derivadas. Las dos probabilidades de cambio suman uno menos el factor exponencial de relajación. Cuando se estiman ambas, esa identidad permite recuperar la suma de tasas mediante un logaritmo, siempre que los datos sean compatibles con el modelo y la incertidumbre se propague.
En concreto, si , y , la inversión da
Estas tasas son de tiempo continuo y difieren de los cocientes entre probabilidades de cambio y duración. La sensibilidad de a un error en es , que crece cuando el registro pierde casi toda la memoria inicial. Si las probabilidades estimadas suman uno o más, no existe una tasa finita positiva que reproduzca exactamente esa matriz mediante este modelo de dos estados; deben examinarse la incertidumbre y la adecuación del modelo.
Con intervalos demasiado largos, casi todos los registros están cerca de la distribución estacionaria. La probabilidad activa todavía informa sobre la razón de tasas, pero la memoria temporal restante puede ser tan pequeña que resulte difícil estimar su suma. Por el contrario, intervalos muy cortos permiten resolver mejor los cambios, aunque requieren una observación suficientemente extensa para acumular eventos y estimar las tasas con precisión.
170.8. Intervención que aumenta k+ a 0,04
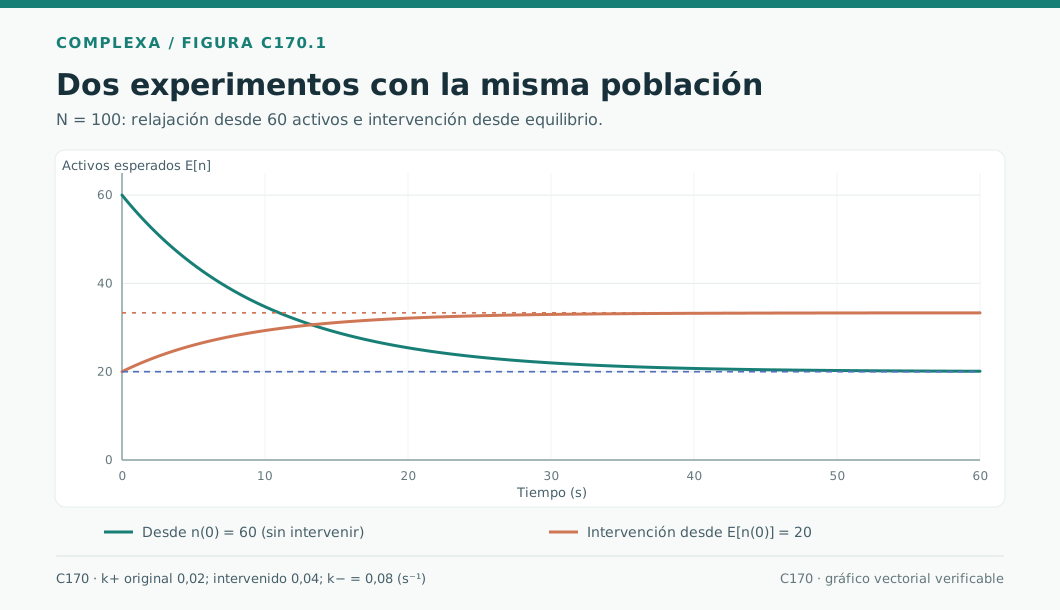
Supongamos que la tasa de activación aumenta a , mientras la tasa de desactivación permanece en . La intervención conserva la independencia y la homogeneidad de las unidades, de modo que las ecuaciones anteriores siguen valiendo con los nuevos parámetros. Cambian a la vez la probabilidad de equilibrio y la escala temporal de relajación.
La nueva media estacionaria es , aproximadamente activos. El aumento de la activación eleva el equilibrio porque favorece la entrada al estado activo respecto de la salida. La suma de tasas también aumenta, por lo que el tiempo característico disminuye. Ambos efectos proceden del mismo cambio paramétrico, aunque describen propiedades diferentes de la respuesta colectiva.
Tomemos como origen temporal el instante de la intervención y supongamos que el sistema estaba en el equilibrio previo, con media veinte. La solución exacta del primer momento con los nuevos parámetros da
La forma con fracciones conserva exactamente el equilibrio y la condición inicial; la forma decimal tiene los coeficientes redondeados. La media aumenta monótonamente desde veinte hacia el nuevo valor estacionario. Esta curva predice un promedio de realizaciones; las trayectorias individuales conservan saltos aleatorios y pueden descender temporalmente aunque la media del conjunto aumente.
La interpretación causal requiere especificar qué información se observa. Conocer solamente la nueva media estacionaria fija la razón entre las tasas, pero deja indeterminada su escala común. Para cualquier factor positivo , reemplazar ambas tasas por y preserva ; en cambio, la tasa de relajación queda multiplicada por ese factor y el tiempo característico se divide por él.
Observar la evolución temporal añade una restricción. Bajo el modelo homogéneo de dos estados, la probabilidad estacionaria y la tasa de relajación determinan las tasas por separado, mediante y . La relajación puede estimarse a partir de una respuesta transitoria o de la autocovarianza estacionaria, siempre que las hipótesis del modelo sean adecuadas.
La inferencia de un mecanismo a partir de una media exige, por tanto, más información que un cambio de nivel. Incluso una identificación algebraicamente única dentro de este modelo depende de haber establecido independencia, homogeneidad y tasas constantes. Procesos con heterogeneidad pueden compartir la media y tener otras escalas temporales. La sección siguiente conserva deliberadamente la estadística estacionaria del indicador y modifica la organización de sus tiempos de relajación.
170.9. Heterogeneidad con dos grupos de 50 unidades
Dividamos ahora la población en dos grupos independientes de cincuenta unidades. El grupo rápido tiene tasas y ; el lento, y , todas en . En ambos casos, la razón entre la tasa de activación y la suma de tasas da la misma probabilidad estacionaria, .
En equilibrio, todos los estados individuales son Bernoulli independientes con idéntica probabilidad, pese a que sus mecanismos evolucionan a velocidades distintas. La distribución estacionaria del total sigue siendo , con media veinte y varianza dieciséis. Una observación de la distribución instantánea de equilibrio no permite distinguir esta población heterogénea de la homogénea estudiada anteriormente.
La diferencia aparece en la estructura temporal. Cada grupo contribuye con una varianza estacionaria de ocho, que se disipa con su propia tasa de relajación. Al sumar las autocovarianzas de ambos grupos independientes, obtenemos una combinación de dos exponenciales. Para retardos positivos, con medido en segundos, la expresión es
En retardo cero, ambas contribuciones suman dieciséis. Al aumentar el retardo, la contribución rápida decae antes y la lenta mantiene una cola más persistente. Una única exponencial no reproduce exactamente esta función en todo el intervalo temporal. La coincidencia de medias y varianzas estacionarias es así compatible con una organización temporal de varias escalas dinámicas.
Además, el número total deja de ser una cadena autónoma de nacimiento y muerte. Escribamos y para los activos rápidos y lentos, respectivamente, con . Las tasas totales de incremento y decremento condicionadas a la composición son
Dos configuraciones con igual total pueden tener distinto número de activos rápidos y, en tal caso, las expresiones anteriores dan tasas diferentes hacia los totales vecinos. El criterio de lumpability respecto del total falla, ya que conocer únicamente no determina la ley del siguiente salto. La pareja sí da una descripción markoviana suficiente, pues registra la composición que las tasas necesitan.
Este ejemplo separa propiedades que pueden coincidir solo en parte. La distribución estacionaria del total permanece binomial, su autocovarianza cambia y su reducción dinámica escalar pierde autonomía. Dos sistemas pueden tener los mismos indicadores estáticos y dinámicas distintas. Para evaluar una reducción hay que comprobar las probabilidades estacionarias, las transiciones condicionadas y las dependencias temporales que la variable agregada conserva o descarta.
En la población heterogénea, la composición oculta produce una diferencia visible incluso sin resolver toda una trayectoria. Consideremos dos configuraciones con veinte activos; en una, todos pertenecen al grupo rápido y, en la otra, al lento. Las tasas totales de nacimiento y muerte son, respectivamente,
La primera composición tiene una deriva inicial negativa y la segunda, positiva, aunque ambas comparten el mismo valor del indicador global. Una ecuación autónoma exacta que dependiera únicamente de ese valor tendría que asignarles la misma deriva, en contra del cálculo. Conservar los dos conteos resuelve el problema y mantiene una descripción mucho menor que la configuración de cien variables binarias.
Este ejemplo también explica por qué un ajuste basado solo en tiempos largos puede parecer satisfactorio. Después de suficiente relajación, ciertas composiciones internas se vuelven más probables que otras y un promedio condicionado puede aproximar parte de la evolución. La calidad de esa aproximación depende de la preparación, del intervalo de observación y de la separación entre velocidades. Una intervención que active selectivamente unidades lentas cambia esos pesos y puede romper la predicción, aunque conserve el mismo número total de activos.
Para comprobarlo se pueden preparar las dos composiciones calculadas y comparar la variación media durante un intervalo breve; la diferencia esperada aparece en el primer orden temporal. El experimento pone a prueba directamente la autonomía del indicador y distingue mecanismos que un histograma estacionario no separa. Funciona porque mantiene constante la variable observada mientras cambia de forma controlada la información que el modelo había omitido.
170.10. Validación y extensiones
El modelo homogéneo puede validarse mediante simulación estocástica exacta con las propensidades globales y ; el algoritmo de Gillespie genera tiempos de espera y tipos de evento compatibles con ellas (Gillespie, 1977). En este capítulo no se ejecutó ninguna simulación; todos los resultados numéricos son analíticos. Toda simulación futura deberá identificarse como dato sintético.
La validación compararía balance, momentos y tiempos de relajación. En equilibrio, se contrastaría la distribución de ocupaciones con la binomial y el balance entre estados vecinos. Los registros de eventos y las observaciones a tiempos uniformes ponderan los estados de forma distinta. Por eso, al estimar la distribución estacionaria temporal desde una trayectoria de saltos, las ocupaciones se ponderan por sus tiempos de permanencia; la frecuencia de visitas da otra distribución.
En el régimen transitorio, se contrastarían la media desde sesenta activos y la varianza, que suma las contribuciones de los dos grupos iniciales. Preparaciones independientes permiten estimar momentos de conjunto; una trayectoria larga sirve para estudiar propiedades estacionarias tras controlar la relajación inicial. Cada comparación debe corresponder a la preparación y al estimador utilizados.
Los tiempos de relajación y la autocovarianza son comprobaciones complementarias, porque una media estacionaria coincidente puede ocultar tasas incorrectas, mientras que una autocovarianza con varias escalas puede revelar heterogeneidad. En el modelo de dos grupos, la simulación exacta conserva los conteos separados; usar propensidades dependientes solo del total introduciría otra dinámica, pues la composición condiciona las transiciones.
Las interacciones limitan la reducción, porque las tasas que dependen de otros estados generan covarianzas cruzadas y pueden exigir momentos superiores para cerrar la ecuación de la media. Las correlaciones iniciales afectan las distribuciones transitorias, aunque la ecuación media del caso independiente conserve su forma. La agregación exacta requiere verificar condiciones del generador (Buchholz, 1994).
Una unidad colectiva observable no implica universalidad automática. Extrapolar a un sistema empírico requiere justificar las variables, las tasas y sus dependencias; los resultados analíticos aquí expuestos corresponden al modelo didáctico y a las preparaciones iniciales especificadas.
Referencias
Buchholz, P. (1994). Exact and ordinary lumpability in finite Markov chains. Journal of Applied Probability, 31(1), 59–75. DOI.
Gillespie, D. T. (1977). Exact stochastic simulation of coupled chemical reactions. The Journal of Physical Chemistry, 81(25), 2340–2361. DOI.