Módulo 27. Evolución, variación y restricciones
265.1. Cuando la población no cabe en una secuencia representativa
Una población de replicadores puede contener numerosas secuencias relacionadas por mutación. Incluso si una de ellas se reproduce más deprisa que las demás, su frecuencia dependerá de cuántos descendientes conservan su secuencia y de cuántos llegan desde otros tipos. La reproducción y la transmisión deben analizarse conjuntamente.
El concepto de cuasiespecie dirige la atención hacia una distribución de variantes conectadas. Junto a la pregunta por la secuencia más rápida, interesa qué composición puede mantenerse mediante reproducción y mutación. Una distribución persistente puede incluir secuencias que, consideradas aisladamente, no ganarían una competencia sin mutación.
El trabajo de Eigen de 1971 es una referencia fundacional de este enfoque [1]. La formulación matemática que usaremos describe frecuencias deterministas de replicadores asexuales con tasas constantes. No se aplica necesariamente a toda población viral ni a cualquier colección de secuencias diferentes.
Una población puede ser diversa sin encontrarse en el régimen descrito por un modelo de cuasiespecies, porque también pueden intervenir deriva, recombinación, estructura espacial, coinfección o cambios ambientales. La adecuación del modelo requiere examinar esos procesos.
Construiremos ejemplos pequeños para mostrar qué información contiene una distribución y cómo se obtiene. Después estudiaremos un modelo de secuencia privilegiada, los llamados umbrales de error y la competencia entre regiones de distinta robustez mutacional.
Conviene separar tres objetos. La secuencia es una cadena concreta de símbolos. El tipo es una categoría del modelo que puede agrupar varias secuencias. La población es el conjunto de copias con sus frecuencias. Intercambiar estos objetos sin avisar puede convertir una simplificación útil en una afirmación equivocada.
Una secuencia consenso también es distinta de una secuencia realmente presente. Si se toma el símbolo más frecuente en cada posición, la combinación resultante puede no aparecer en ninguna copia. Por ello, resumir una población mediante un consenso puede ocultar asociaciones entre posiciones.
La cuestión central será dinámica (cómo se producen los descendientes y cómo cambia la composición). Las metáforas de nube o paisaje son útiles cuando acompañan reglas explícitas; sin ellas, describen una imagen que no permite calcular qué distribución persistirá ni bajo qué condiciones.
265.2. La matriz que conecta reproducción y mutación
Supongamos que hay K tipos. La frecuencia del tipo j es x sub j y su producción esperada de descendientes es w sub j. Definamos Q sub ij como la probabilidad de que un descendiente del tipo j pertenezca al tipo i.
Cada columna de Q suma uno porque distribuye todos los destinos posibles de un descendiente. Esta convención debe declararse, ya que otros textos usan filas para representar los tipos parentales y transponen así las matrices.
Antes de normalizar, la producción del tipo i es la suma de las contribuciones de todos los padres
La producción total es la aptitud media, siempre que Q incluya todos los destinos y sus columnas sumen uno. Las frecuencias de la siguiente generación son
Definamos W como Q multiplicada por la matriz diagonal de aptitudes. La actualización consiste entonces en multiplicar el vector de frecuencias por W y normalizar su suma. La no linealidad de las frecuencias procede del denominador compartido.
Si trabajamos con números de copias sin regulación de tamaño, la misma matriz puede describir una dinámica lineal de abundancias. Sin embargo, la interpretación de w debe ser compatible con ese crecimiento absoluto, porque con una aptitud relativa escalada arbitrariamente no se puede predecir cuántas copias habrá.
Una distribución estacionaria cumple que W por x es proporcional a x. El factor de proporcionalidad coincide con la aptitud media estacionaria en este modelo. Por tanto, la distribución es un vector propio no negativo de la matriz de reproducción y mutación.
Cuando W es estrictamente positiva, el teorema de Perron–Frobenius garantiza un valor propio dominante y un vector propio positivo único salvo escala, que la normalización permite interpretar como frecuencias. Bajo esas condiciones, las iteraciones desde una población no nula se aproximan a esa composición.
Si la matriz no es positiva, hay que examinar conectividad, periodicidad y clases inaccesibles. La mera existencia de una matriz no garantiza convergencia universal. Una población inicial que no puede alcanzar ciertos tipos puede quedar restringida a una parte del espacio.
La ventaja práctica de esta formulación es que obliga a declarar de dónde procede cada descendiente. Una secuencia frecuente puede mantenerse tanto por reproducción propia como por entradas mutacionales. Conocer solo la frecuencia final no permite saber cuál de esas contribuciones domina.
265.3. Un ejemplo de dos tipos resuelto paso a paso
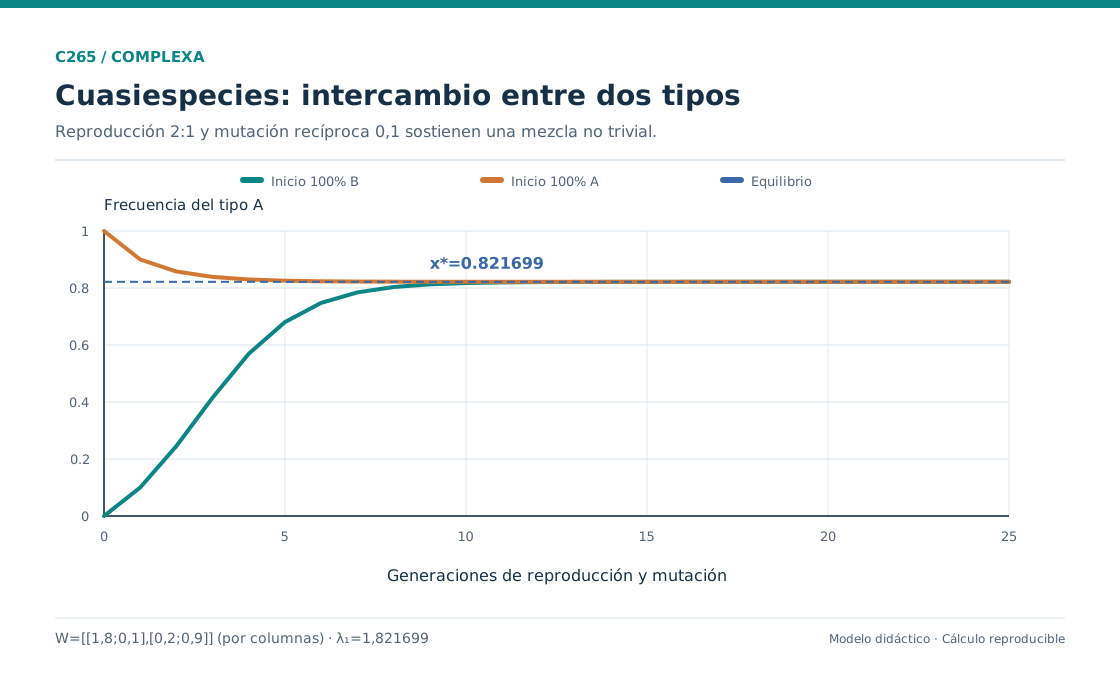
Consideremos dos tipos, A y B. A produce dos descendientes por unidad de referencia y B produce uno. Cada descendiente conserva el tipo parental con probabilidad 0,9 y cambia al otro tipo con probabilidad 0,1.
La matriz de reproducción y mutación es
La primera columna recoge los descendientes de A, con 1,8 copias esperadas de A y 0,2 de B. La segunda recoge los de B, con 0,1 de A y 0,9 de B. Las sumas de columnas recuperan las producciones dos y uno.
Si x es la frecuencia de A, su actualización es
Con una población inicial formada solamente por B, la siguiente frecuencia de A es 0,1, porque la mutación introduce un tipo que estaba ausente. Con una población formada solamente por A, la siguiente frecuencia de A es 0,9, de modo que la fijación tampoco permanece.
La condición estacionaria produce una ecuación cuadrática cuya raíz admisible es
La frecuencia de B es aproximadamente 0,178301. A conserva la mayor frecuencia, pero no ocupa toda la población. La transmisión imperfecta sostiene una presencia considerable del tipo de menor reproducción.
La aptitud media estacionaria es uno más x, aproximadamente 1,821699. Ese número coincide con el valor propio dominante de W. El otro valor propio es aproximadamente 0,878301 y no determina la composición persistente desde una condición inicial positiva.
Podemos comprobar el flujo directamente. En el equilibrio, A produce aproximadamente 1,479058 descendientes A por unidad de población parental y B produce otros 0,017830. La suma, dividida por 1,821699, devuelve la frecuencia 0,821699.
La producción de B también combina dos orígenes, los descendientes mutados desde A y los conservados de B. Aunque cada copia de B produzca menos, B recibe una entrada continua desde el tipo más abundante. El equilibrio describe ese intercambio; las aptitudes individuales siguen siendo distintas.
Si observáramos solamente el tipo más frecuente, perderíamos casi el dieciocho por ciento de la composición. Si registráramos únicamente la aptitud máxima, predeciríamos mal la producción media. El ejemplo muestra por qué distribución, transmisión y rendimiento deben mantenerse como variables separadas.
El valor propio dominante describe el crecimiento asintótico de abundancias bajo la interpretación lineal, mientras que la velocidad de ajuste de las proporciones depende también de los otros modos de la matriz y de la composición inicial. Dos sistemas pueden compartir distribución estacionaria y aproximarse a ella a ritmos distintos.
En el ejemplo de dos tipos, el cociente entre el valor propio secundario y el dominante es aproximadamente 0,4821. La contribución relativa de ese modo disminuye geométricamente al iterar la matriz y la normalización transforma esa reducción en una aproximación de las frecuencias hacia la distribución estacionaria.
Esta explicación supone que podemos descomponer el estado en los modos pertinentes y que el dominante está separado de los demás. Si varios valores propios tienen magnitudes cercanas, el ajuste puede ser lento y una observación transitoria puede parecer estable antes de que desaparezca la contribución de otros modos.
Por eso, una estimación experimental de composición debe acompañarse de un horizonte temporal. Varias generaciones sin cambios detectables pueden coexistir con modos transitorios todavía presentes. La precisión del instrumento y la separación entre escalas dinámicas condicionan lo que podemos concluir.
265.4. De mutaciones por posición a fidelidad de la secuencia completa
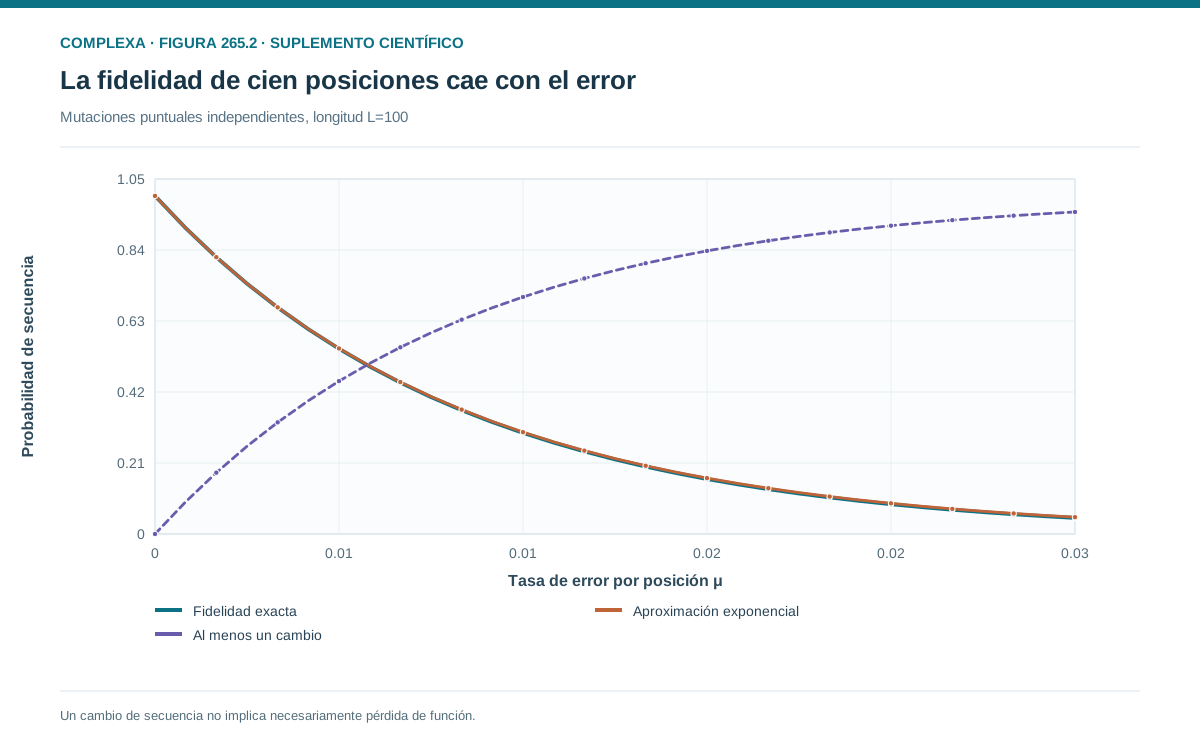
Una tasa de error por posición no es la probabilidad de conservar una secuencia entera. Si una cadena contiene L posiciones y cada una se copia correctamente con probabilidad uno menos mu, de manera independiente, la fidelidad completa es
Con cien posiciones y una tasa de error por posición de 0,001, la fidelidad completa es aproximadamente 0,90479 y la probabilidad de al menos un cambio ronda 0,09521. Un error pequeño por posición puede acumular un efecto apreciable en una cadena larga.
Con la misma longitud y una tasa de 0,01, la fidelidad baja a aproximadamente 0,36603, así que más de la mitad de los descendientes difiere en alguna posición. La fórmula solo describe identidad de secuencia; no implica que todos esos cambios sean funcionalmente perjudiciales.
Para tasas pequeñas, el logaritmo de la fidelidad se aproxima a menos L por mu, de donde surge la aproximación exponencial. Su calidad depende de que la longitud multiplicada por los términos descartados sea pequeña, algo que un mu en apariencia pequeño escrito en decimal no asegura.
El número de cambios sigue una distribución binomial bajo independencia y probabilidades iguales. Su media es L por mu, pero una media de un cambio no significa que cada descendiente tenga exactamente uno.
La independencia es un supuesto. Errores correlacionados, inserciones, deleciones y variación entre posiciones pueden requerir otra matriz de mutación. Una única tasa promedio puede ocultar rutas muy distintas hacia determinados tipos.
También debemos distinguir cambios de secuencia de cambios de función. Dos secuencias diferentes pueden producir el mismo resultado funcional en un ensayo. Una fidelidad de secuencia baja puede coexistir con una conservación funcional considerable si muchas mutaciones son toleradas.
La distancia de Hamming cuenta posiciones diferentes entre cadenas de igual longitud. Puede ayudar a agrupar secuencias, aunque sin información adicional no mide distancia funcional. Un cambio en una posición decisiva puede importar más que varios cambios en posiciones tolerantes.
Por último, una probabilidad de error se define respecto de un proceso concreto de copia. Si hay reparación o selección antes de medir descendientes, la distribución observada puede diferir de la distribución inicial de errores. El momento del muestreo vuelve a formar parte de la variable.
265.5. Una secuencia privilegiada y un umbral calculable
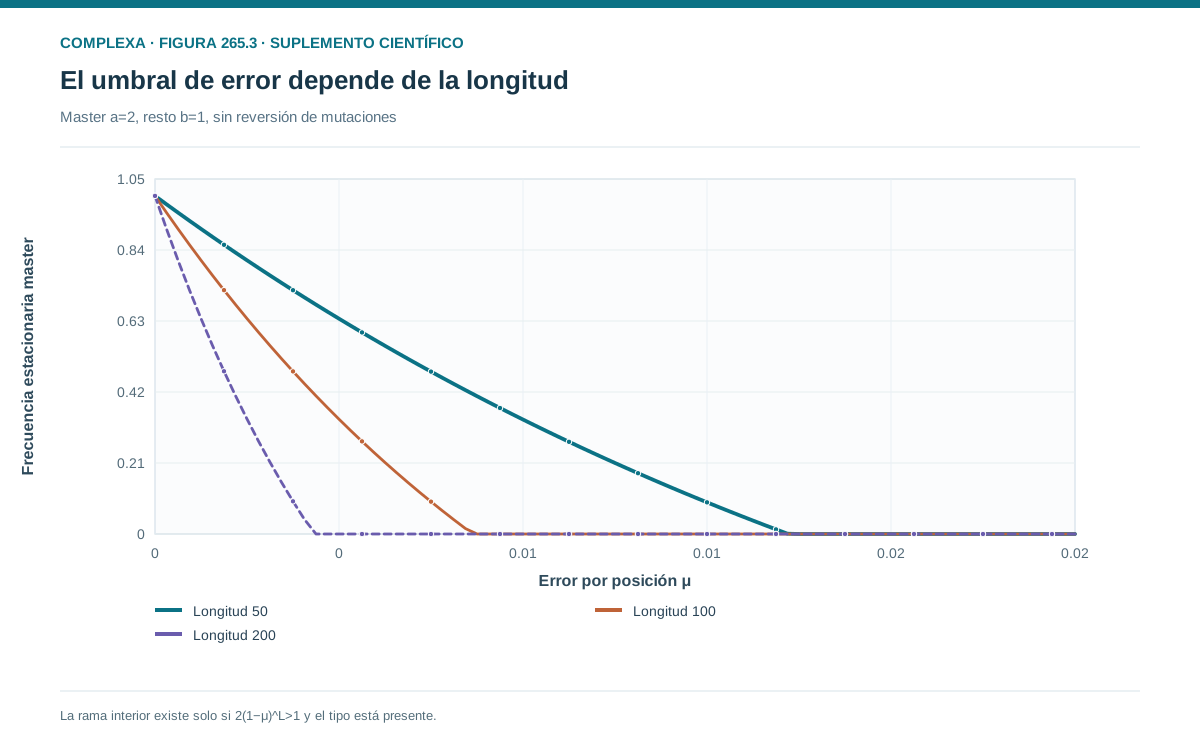
Construyamos un modelo de dos clases. La primera contiene una secuencia privilegiada que se reproduce con tasa a. La segunda agrupa todas las demás y tiene tasa b, con a mayor que b. Supondremos que no hay retorno desde la segunda clase hacia la primera.
Una copia de la secuencia privilegiada conserva su identidad con probabilidad Q y las copias que cambian pasan a la segunda clase. Bajo estas reglas, la frecuencia x de la primera clase evoluciona según
Junto al equilibrio cero, existe una solución interior
si a por Q supera b. La condición compara la producción fiel de la secuencia privilegiada con la reproducción de la clase alternativa. La ventaja de reproducción puede perderse si la fidelidad es suficientemente baja.
Tomemos a igual a dos y b igual a uno. El equilibrio interior es dos por Q menos uno. Si Q es 0,9, la frecuencia estacionaria es 0,8; si Q es 0,6, baja a 0,2. Por debajo de 0,5, no existe un equilibrio interior positivo.
Si Q procede de cien posiciones independientes, el valor crítico de mu es uno menos dos elevado a menos una centésima, aproximadamente 0,0069075. La aproximación logaritmo de dos dividido por cien da 0,0069315.
La cercanía entre ambos números ilustra la utilidad de la aproximación, aunque no elimina la diferencia. Para comunicar un umbral preciso conviene indicar si se calculó con la expresión exacta o con una expansión.
Una simplificación fuerte del modelo es que no permite recrear la secuencia privilegiada desde las demás. Esa aproximación puede ser razonable en ciertos límites, pero no es una propiedad universal de secuencias finitas. Si existe retorno, la frecuencia de esa secuencia puede permanecer positiva incluso cuando es muy pequeña.
También hemos asignado la misma aptitud a todas las secuencias alternativas. Un paisaje heterogéneo puede producir transiciones diferentes o carecer de un umbral abrupto comparable. La fórmula vale para este paisaje y estas reglas.
El resultado tampoco describe necesariamente un descenso instantáneo. Cerca de un umbral pueden aparecer tiempos prolongados de ajuste. Una población observada durante pocas generaciones puede conservar una composición heredada del régimen anterior y dificultar la localización empírica de la transición.
265.6. Pérdida de localización no equivale a extinción
La expresión «catástrofe de error» puede sugerir que la población desaparece. Sin embargo, una ecuación de frecuencias conserva por construcción una suma igual a uno y no contiene información suficiente para decidir si el número total de replicadores crece, disminuye o se extingue.
En el modelo anterior, cuando la secuencia privilegiada pierde su presencia estable, la clase alternativa puede seguir reproduciéndose. La transición describe un cambio de composición y de localización en el espacio de secuencias. La extinción exige un modelo demográfico adicional.
Imaginemos que todas las tasas reproductivas se multiplican por un mismo factor. Las frecuencias evolucionan de la misma manera, porque el factor se cancela al normalizar. En cambio, las abundancias absolutas pueden crecer con un factor y disminuir con otro.
Por ejemplo, la matriz de dos tipos del apartado tercero tiene valor propio dominante cercano a 1,8217. Si se interpreta como producción absoluta por generación sin otras pérdidas, permite crecimiento. Si todas sus entradas se multiplican por 0,4, el valor dominante baja a aproximadamente 0,7287 y las abundancias disminuyen, aunque la composición estacionaria sea idéntica.
Esta comparación muestra que composición y persistencia demográfica responden a preguntas diferentes. Para estudiar extinción debemos incorporar supervivencia, recursos, eliminación, tamaños iniciales y fluctuaciones.
En sistemas finitos también puede perderse una secuencia por azar antes de alcanzar un umbral determinista. Si no existe una ruta de reintroducción, esa pérdida será irreversible dentro del modelo; si existe retorno, la ausencia puede ser temporal.
Una distribución estacionaria suave en un sistema pequeño tampoco excluye una transición más definida en un límite de longitud o tamaño. Los límites matemáticos deben declararse, porque una discontinuidad idealizada puede convertirse en un cambio gradual cuando se observan poblaciones finitas.
Al interpretar experimentos con mutágenos o replicadores, una reducción de abundancia, un aumento de diversidad y la pérdida de una secuencia dominante son resultados distintos. Pueden coincidir, pero ninguno implica necesariamente los otros.
El vocabulario debe seguir a la variable medida. Hablar de desaparición de un genotipo, dispersión de frecuencias o extinción poblacional permite identificar qué evidencia se necesita. Usar una sola etiqueta para todos esos fenómenos dificulta tanto la comparación como la explicación causal.
265.7. Reproducción rápida y robustez mutacional
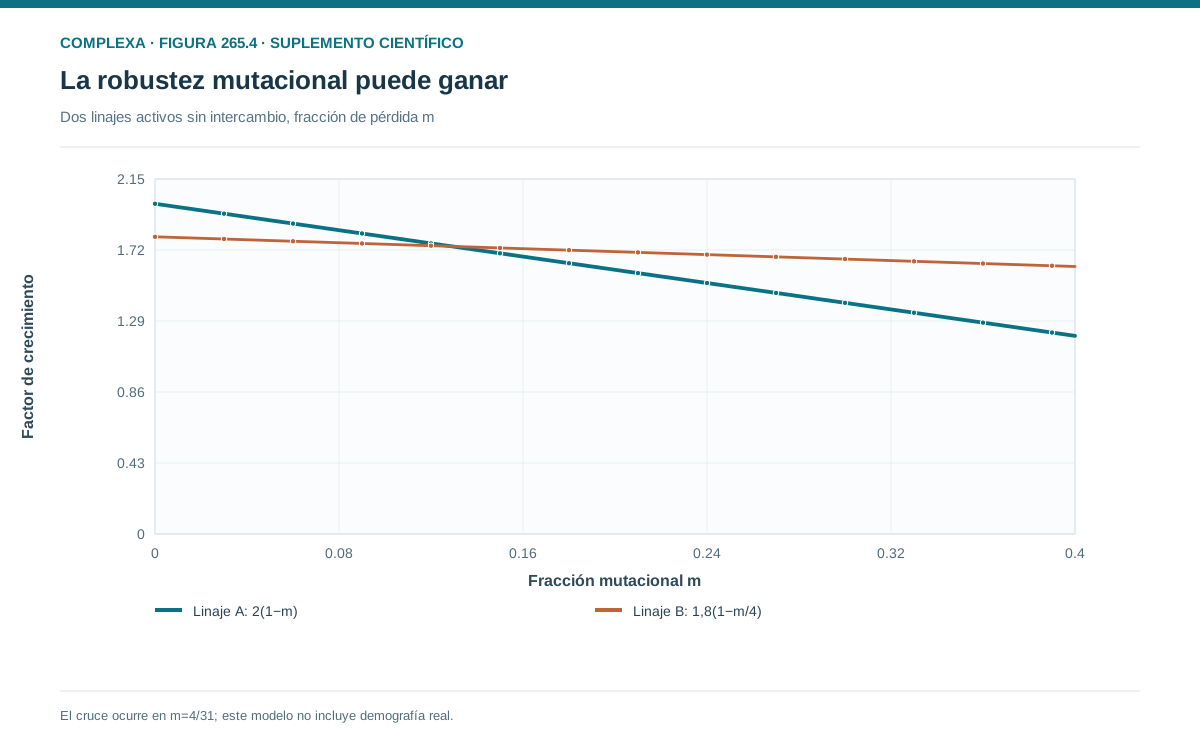
Dos regiones del espacio de secuencias pueden diferir en reproducción y tolerancia a mutaciones. Una región puede contener una secuencia muy rápida cuyos descendientes mutados pierden función. Otra puede tener reproducción algo menor, pero conservar actividad después de muchos cambios.
Para ilustrarlo, supongamos dos linajes sin intercambio entre ellos. El primero produce dos descendientes potenciales por copia y pierde una fracción m hacia estados estériles. El segundo produce 1,8 y pierde solamente una fracción m dividida por cuatro.
Sus factores de crecimiento de copias activas son
Cuando m es cero, el primer linaje crece más deprisa. Cuando m es 0,2, sus factores son 1,6 y 1,71, de modo que el segundo crece más. El punto de igualdad se encuentra en m igual a cuatro treintaiunavos, aproximadamente 0,12903.
Este ejemplo agregado supone que las pérdidas son definitivas y que las copias activas de cada linaje comparten el mismo factor efectivo. Sin representar toda la geometría de una red de secuencias, permite aislar cómo la retención de función puede compensar una producción menor.
La comparación tampoco implica que la mutación beneficie directamente a cada copia. El resultado depende del conjunto de descendientes y de cuántos permanecen reproductivamente activos. Una secuencia rápida puede perder frente a otra cuando se consideran los efectos recurrentes de sus mutaciones.
Wilke y colaboradores estudiaron este tipo de inversión competitiva en organismos digitales [2]. Sus experimentos mostraron que, al aumentar la tasa de mutación, podían prevalecer poblaciones situadas en regiones más robustas pese a tener genotipos dominantes de menor velocidad de replicación. El resultado corresponde a ese sistema experimental y no garantiza que toda población natural siga el mismo patrón.
La expresión «supervivencia de los más planos» alude a esa robustez del entorno mutacional. La palabra «plano» necesita una definición operacional (distribución de efectos de mutaciones, retención funcional o propiedades de conectividad). Un dibujo de un pico ancho no sustituye la medición.
Si cambian las tasas de mutación o el ambiente, puede cambiar también el ganador. La robustez depende del conjunto de perturbaciones considerado. Una región tolerante a sustituciones puntuales puede ser vulnerable a deleciones o a cambios de temperatura.
La predicción más útil consiste en relacionar reproducción basal, espectro de mutaciones y crecimiento efectivo. Medir solamente la primera puede dejar fuera precisamente el mecanismo que decide la competencia.
265.8. Secuenciación, agrupación y observación de la distribución
Una muestra de secuencias contiene información parcial de la población. Las variantes raras pueden no aparecer y los errores de medición pueden crear variantes aparentes. Antes de interpretar una nube mutacional, debemos separar la variación biológica de la introducida por el procedimiento.
Si una variante tiene frecuencia real de uno por mil y se toman cien copias independientes, la probabilidad de no detectarla es 0,999 elevado a cien, aproximadamente 0,9048. Su ausencia en esa muestra dice poco sobre su ausencia en la población.
El tamaño de muestra debe ajustarse a la frecuencia que se pretende detectar. También puede fallar la independencia si varias lecturas proceden de una misma molécula amplificada. Contar lecturas no siempre equivale a contar copias biológicas independientes.
La agrupación de secuencias también modifica el análisis. Si se agrupan todas las variantes a una misma distancia de una referencia, se pierde información sobre posiciones y funciones. Dos clases de igual distancia pueden tener aptitudes y rutas de retorno diferentes.
Una reducción por clases será exacta solo bajo condiciones que permitan describir sus transiciones sin conocer la composición interna. Si esas condiciones no se cumplen, la dinámica agregada puede depender de información oculta dentro de cada clase.
El consenso, la diversidad total y la frecuencia del tipo dominante son resúmenes complementarios. Dos poblaciones pueden compartir consenso y diferir ampliamente en diversidad. También pueden tener igual diversidad y ocupar regiones funcionalmente distintas del espacio.
Para contrastar un modelo conviene obtener series temporales además de una muestra final. Una distribución parecida a la estacionaria puede haberse producido por condiciones iniciales particulares o por mezcla de subpoblaciones. La respuesta a una perturbación añade restricciones.
La medición de aptitud debería ser compatible con el ambiente y con el nivel de agregación. Una tasa obtenida para una secuencia aislada puede diferir de su contribución cuando hay interacciones entre replicadores. Si esas interacciones son apreciables, la matriz constante deja de capturar toda la dinámica.
Una inferencia sólida conecta qué secuencias se observan, cómo se transforman unas en otras y cuánto contribuyen a la reproducción. Ninguno de estos componentes puede deducirse por completo de los otros dos sin supuestos adicionales.
Un ejemplo mínimo permite ver la diferencia entre consenso y presencia. Consideremos la secuencia binaria 000 con frecuencia 0,40, la secuencia 110 con frecuencia 0,35 y la secuencia 101 con frecuencia 0,25. En la primera posición, el símbolo uno tiene frecuencia 0,60; en la segunda y la tercera predominan los ceros.
Por tanto, el consenso formado por mayorías es 100, una secuencia ausente de la población construida. No hay error aritmético, porque cada posición se resume por separado y después se combinan mayorías que no necesariamente coexisten en una misma copia. El consenso conserva información marginal y pierde asociaciones.
Si sintetizáramos esa secuencia consenso para medir su reproducción, estaríamos estudiando una entidad nueva respecto de la muestra original. Su rendimiento podría ser mayor, menor o igual al de las variantes presentes y no puede deducirse únicamente de las frecuencias por posición.
La probabilidad de que dos copias tomadas independientemente sean diferentes es otro resumen. En este ejemplo es uno menos la suma de los cuadrados de las tres frecuencias, que da 0,655. Ese valor cuantifica diversidad de tipos, pero no informa sobre la función de las diferencias.
Podemos permutar los nombres o las secuencias asociadas a esas frecuencias y mantener exactamente el mismo índice, aunque la población resultante podría ocupar regiones muy distintas de un paisaje funcional. Por ello, un índice de diversidad debe interpretarse junto con la identidad de las variantes.
Incluso una medida basada en distancias necesita especificar su significado. Una distancia media pequeña puede indicar proximidad de secuencia y, al mismo tiempo, incluir cambios funcionalmente decisivos. La relevancia biológica de la distribución requiere conectar identidad, posición y efecto.
La regla de análisis que se desprende de estos ejemplos es que cada resumen responde a una pregunta concreta. Antes de usarlo como evidencia de adaptación, robustez o pérdida de información, debemos mostrar qué relación existe entre la cantidad calculada y el mecanismo que queremos evaluar.
265.9. Construir y verificar un modelo reproducible
Un modelo pequeño permite hacer comprobaciones que deberían mantenerse en aplicaciones grandes. Primero se define el conjunto de tipos y se especifica si incluye estados no funcionales. Después se construye la matriz de mutación con probabilidades no negativas y columnas normalizadas.
Las aptitudes deben tener unidades y un punto del ciclo definido. Si describen descendientes esperados antes de eliminación, esa eliminación debe aparecer en otro paso; si ya la incorporan, no debe aplicarse de nuevo.
La actualización puede calcularse aplicando sucesivamente reproducción, transformación y normalización. En cada iteración verificamos que las frecuencias sean no negativas y sumen uno. Una pérdida sistemática de masa suele indicar destinos omitidos o una convención de filas y columnas mezclada.
El ejemplo de dos tipos es una prueba independiente. La solución por iteración debe aproximarse a 0,821699 para A y 0,178301 para B. El producto matricial en esa composición debe ser proporcional al vector original con factor cercano a 1,821699.
También conviene ensayar casos límite. Sin mutación, el tipo de mayor reproducción debería aumentar desde una frecuencia positiva. Con aptitudes iguales, la dinámica debe reducirse a la transformación por Q. Con una matriz identidad, no hay cambios de tipo durante la transmisión.
En una simulación finita, los resultados de una sola réplica no tienen por qué coincidir con la trayectoria determinista. Se necesitan varias réplicas y una comparación entre medias, dispersión y probabilidad de pérdida, porque la distribución de resultados puede revelar diferencias que una curva promedio oculta.
La sensibilidad a la condición inicial informa sobre accesibilidad. Si dos inicializaciones conducen a resultados distintos, debemos comprobar si la matriz es reducible, si existen clases desconectadas o si se introdujo alguna dependencia de frecuencias.
Una auditoría de parámetros debe conservar los valores originales y el procedimiento usado para estimarlos. Ajustar una matriz completa a pocos datos puede producir múltiples soluciones aparentemente precisas. La incertidumbre de las entradas se transmite a la distribución predicha.
Finalmente, los límites de la agregación deben acompañar al resultado. Un modelo con dos clases puede explicar una competencia específica, pero no por ello reconstruye todas las secuencias individuales. La resolución de la conclusión debe corresponder a la del modelo y de las observaciones.
265.10. La distribución como objeto evolutivo
La teoría de cuasiespecies muestra que reproducción y fidelidad de transmisión actúan conjuntamente sobre la composición de una población. La secuencia de mayor reproducción aislada no siempre permite predecir qué conjunto de variantes persistirá.
Una matriz de reproducción y mutación permite formular ese problema con precisión. Bajo condiciones apropiadas, su vector propio dominante describe la composición estacionaria. La conectividad determina qué tipos son accesibles y la normalización separa frecuencias de abundancias.
Los umbrales de error pertenecen a modelos y límites concretos. La pérdida de una secuencia dominante no implica necesariamente extinción. Tampoco la diversidad de una población, sin más evidencia, identifica una transición de ese tipo. El paisaje, la mutación inversa y el tamaño finito pueden modificar el resultado.
La robustez mutacional introduce una segunda dimensión junto a la reproducción basal. Un linaje puede compensar menor velocidad conservando una mayor proporción de descendientes funcionales. Esa posibilidad debe probarse con el espectro real de perturbaciones, que una metáfora espacial no puede sustituir.
Al observar poblaciones, necesitamos conservar información sobre frecuencias, asociaciones entre posiciones y error de medición. Los resúmenes son útiles, pero cada uno pierde una parte distinta de la estructura. Una secuencia consenso no reemplaza la distribución que la produjo.
El siguiente capítulo examinará cómo las secuencias se relacionan con características observables mediante procesos de desarrollo. La matriz de mutación describe conexiones entre genotipos; comprender sus consecuencias requiere también estudiar el mapa que conecta esos genotipos con fenotipos y ambientes.
Referencias
[1] Eigen, M. (1971). Selforganization of matter and the evolution of biological macromolecules. Naturwissenschaften, 58, 465–523. DOI.
[2] Wilke, C. O., Wang, J. L., Ofria, C., Lenski, R. E., y Adami, C. (2001). Evolution of digital organisms at high mutation rates leads to survival of the flattest. Nature, 412, 331–333. DOI.