Dos procesos pueden tener la misma correlación entre una observación y la siguiente y exigir, sin embargo, registros de duración muy distinta para estimar su media. Imaginemos dos instrumentos que entregan una lectura por hora. En unidades normalizadas, sus registros tienen media cero, varianza uno y una correlación cercana a cuatro décimas entre horas consecutivas. Hasta ahí, la descripción parece bastar para considerarlos igual de persistentes. La diferencia aparece cuando se pregunta cuánto influye una lectura sobre otras separadas por diez, cien o mil horas.
Construiremos ambos procesos como ejemplos matemáticos, sin atribuirlos a ningún dispositivo real. En el primero las correlaciones disminuyen geométricamente; en el segundo, correlaciones pequeñas se extienden a retardos cada vez mayores siguiendo una ley de potencia. Una correlación lejana puede ser diminuta y contribuir, aun así, de forma acumulativa a la incertidumbre de un promedio. Por eso el alcance de la memoria importa tanto para describir una señal como para decidir qué precisión puede obtenerse de ella.
La palabra memoria no alude aquí a que el sistema guarde una representación consciente de su pasado. Designa una propiedad de la dependencia temporal dentro de un modelo probabilístico. Esa propiedad no se decide contando rachas largas en un gráfico. Una racha puede deberse a una fluctuación aleatoria, a una tendencia o a que una condición externa cambió durante el registro. Hay que especificar qué objeto permanece estable y cómo disminuye su dependencia a medida que se separan las observaciones.
Definición de memoria larga
Sea una serie estacionaria de segundo orden, es decir, con media constante , varianza finita y autocovarianza que depende solo del retardo. Si la varianza es positiva, la autocorrelación es . Comparar retardos tiene sentido porque una misma separación temporal corresponde a la misma relación de covarianza en todo el proceso.
Una definición habitual de memoria corta exige que la suma de los valores absolutos de las autocovarianzas sea finita. Para la memoria larga persistente que estudiaremos usaremos una clase más específica, la de colas positivas con comportamiento
El símbolo de equivalencia indica que el cociente entre ambos lados tiende a uno cuando el retardo crece. El exponente de la caída está entre menos uno y cero, de manera que cada término tiende a cero mientras su suma diverge; las dependencias lejanas acumulan una contribución total infinita. La definición describe un comportamiento asintótico del proceso y ningún registro finito contiene directamente todos los retardos que intervienen en ella.
Existen convenciones más amplias y otras formas de dependencia de largo alcance, por lo que es recomendable declarar la que se usa, sobre todo cuando aparecen correlaciones negativas, componentes periódicas o momentos que no existen. Un seno con fase aleatoria puede tener covarianzas que no decaen y es, sin embargo, una oscilación persistente, ajena a la cola aperiódica de potencias que acabamos de definir. Precisar qué clase se estudia evita que una suma divergente reúna fenómenos de significado muy diferente.
Para el primer instrumento elegimos un proceso autorregresivo estacionario de primer orden, con coeficiente , innovaciones gaussianas independientes de varianza y distribución inicial estacionaria. Así, la varianza del estado es uno y su autocorrelación vale . La suma de correlaciones es finita porque el coeficiente queda estrictamente por debajo de uno.
Un coeficiente mucho más próximo a uno alargaría considerablemente la persistencia sin cambiar esa conclusión. Con un valor de , la correlación tarda unos cincuenta pasos en reducirse por un factor . Ese plazo puede parecer largo al observador y sigue siendo una escala finita del modelo. Lo que distingue la memoria larga en sentido técnico de una relajación lenta es el comportamiento de la cola cuando el horizonte crece, con independencia de que una parezca intensa y la otra débil.
La sumabilidad de las covarianzas no basta para justificar cualquier teorema central del límite, porque la distribución de un promedio depende de otras propiedades del proceso. En nuestros ejemplos gaussianos el promedio es normal por construcción y su varianza puede calcularse sin aproximaciones asintóticas. Fuera de ese contexto, distinguir entre la escala de la varianza y la forma de la distribución evita conceder más de lo que se ha demostrado.
Incrementos fraccionarios y el significado de H
El segundo instrumento se construye con ruido gaussiano fraccionario. Partimos de un movimiento browniano fraccionario , normalizado para que un incremento de longitud uno tenga varianza uno. Es un proceso gaussiano con incrementos estacionarios y una propiedad de autosimilitud, según la cual multiplicar el tiempo por una constante positiva cambia su distribución como si la amplitud se multiplicara por esa constante elevada a . La igualdad es distribucional y no permite superponer exactamente una trayectoria y una copia ampliada de ella.
Mandelbrot y Van Ness (1968) desarrollaron esta familia de procesos y sus incrementos. En ella, los niveles del movimiento browniano fraccionario tienen varianza proporcional a y no forman, por tanto, una serie estacionaria. La secuencia de incrementos , en cambio, sí lo es. Confundir niveles con incrementos cambia tanto el objeto analizado como la interpretación del exponente.
Para incrementos de varianza uno, la autocorrelación es
La expresión es una segunda diferencia de una potencia. Su desarrollo para retardos grandes da , así que, si el exponente de autosimilitud está entre un medio y uno, el coeficiente es positivo y la cola pertenece a la clase de memoria larga definida antes. Para el segundo instrumento fijamos .
Con esta elección, la correlación en el primer retardo vale exactamente , la misma del instrumento autorregresivo. En los retardos posteriores las diferencias son notables, como muestra la tabla.
| Retardo en horas | Autorregresivo | Ruido fraccionario |
|---|---|---|
| 1 | 0,41421 | 0,41421 |
| 10 | 0,000149 | 0,11866 |
| 100 | aproximadamente | 0,03750 |
El primer retardo no permite reconstruir la cola. Quien conserve solo esa cifra pierde justamente la diferencia que más pesa al promediar registros largos. Del mismo modo, ajustar un autorregresivo de orden bajo porque reproduce bien unas pocas correlaciones puede dejar sin representar la dependencia a escalas mayores. Es una cuestión de adecuación del modelo al objetivo y no un defecto automático de los modelos autorregresivos.
En esta familia, el caso da incrementos gaussianos independientes. Para valores entre cero y un medio, las correlaciones en retardos positivos son negativas, su suma absoluta es finita y la suma completa de covarianzas sufre una cancelación que modifica el escalamiento del promedio. La frase «todo valor distinto de un medio demuestra memoria larga» no corresponde, entonces, a nuestra definición. La persistencia positiva y la antipersistencia requieren interpretaciones distintas.
La misma distinción reaparece en frecuencia. Con una convención espectral en la que integrar la densidad sobre las frecuencias angulares entre menos pi y pi devuelve la varianza, la cola persistente corresponde, bajo las condiciones de regularidad pertinentes, a una divergencia de la densidad cerca de la frecuencia cero. En este modelo esa divergencia es proporcional a , con , de modo que en nuestro ejemplo el exponente espectral vale un medio.
El intervalo mantiene integrable esa divergencia. Una ley exactamente inversa a la frecuencia, prolongada hasta cero, no tendría varianza finita dentro de este modelo estacionario. Una pendiente parecida a esa ley, observada en una banda limitada, no plantea por sí sola tal contradicción, porque puede cambiar fuera de la banda o la serie puede no ser estacionaria. La descripción del resultado debe incluir el rango de frecuencias y si se analizaron niveles o diferencias.
Tomar diferencias tiene un efecto calculable sobre ese espectro. Restar a cada dato su predecesor multiplica la densidad espectral por ; cerca de la frecuencia cero, ese factor se comporta como el cuadrado de la frecuencia. La pendiente de las diferencias no puede interpretarse, por tanto, con la fórmula de los niveles sin tener en cuenta la transformación, que atenúa la variación lenta y puede alterar también la dependencia de corto alcance.
Un ejemplo elemental muestra esa segunda consecuencia. Si los datos originales fueran ruido blanco de varianza uno, sus diferencias tendrían varianza dos y covarianza menos uno en el primer retardo. La correlación inmediata sería negativa porque dos diferencias consecutivas contienen la misma observación con signos opuestos. En retardos mayores, la covarianza volvería a cero. La antipersistencia resultante procede del procesamiento de los datos, sin que haga falta ningún mecanismo de retroalimentación en el fenómeno observado.
Es útil, por eso, guardar junto al resultado una descripción de la serie de entrada (lecturas originales, incrementos físicos o diferencias calculadas después). Dos análisis que dan el mismo nombre a su exponente pueden estar hablando de objetos distintos. Antes de comparar valores hay que reconstruir esas operaciones.
Cuánto se gana al prolongar un registro
Para cualquier proceso con las covarianzas anteriores, la varianza de la media de observaciones es
La expresión cuenta cuántas parejas de observaciones hay a cada separación; con observaciones independientes solo queda el primer término, mientras que con dependencia positiva las parejas añaden incertidumbre. Dividir la varianza marginal por el número de mediciones no basta, porque varias lecturas contienen fluctuaciones relacionadas.
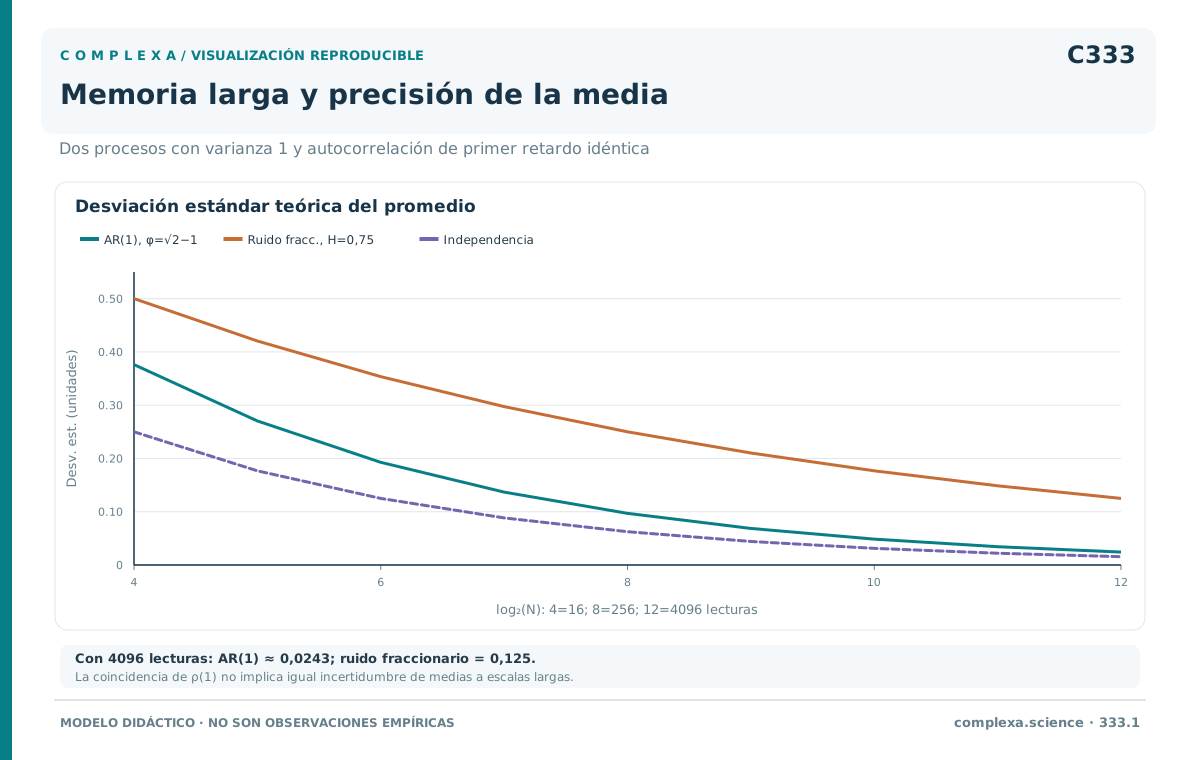
En el proceso autorregresivo elegido, la varianza de la media tiende, para registros largos, a , con un factor mayor que uno pero finito delante del inverso de la duración. En el ruido fraccionario, la suma de los incrementos se telescopa y da un incremento del movimiento browniano fraccionario de longitud total , cuya varianza es exactamente . La varianza de la media es entonces , que aquí equivale a .
Las desviaciones estándar de las medias pueden compararse sin generar ninguna realización aleatoria. La tabla las recoge para tres longitudes de registro.
| Número de lecturas | Autorregresivo | Ruido fraccionario |
|---|---|---|
| 16 | 0,3761 | 0,5000 |
| 256 | 0,0969 | 0,2500 |
| 4.096 | 0,0243 | 0,1250 |
Los dos instrumentos comparten varianza marginal y correlación inmediata y, sin embargo, después de miles de lecturas sus medias tienen precisiones muy diferentes. En el segundo, cuadruplicar la duración reduce la desviación estándar por un factor raíz de dos, de modo que para reducirla a la mitad hay que multiplicar la duración por dieciséis. En el primero, una vez alcanzado el régimen de registros largos, cuadruplicar la duración casi la reduce a la mitad.
A veces esta pérdida se expresa mediante un número efectivo de observaciones. Si se define únicamente igualando la varianza de la media con la de observaciones independientes de varianza uno, las 4.096 lecturas equivalen a unas 1.697 en el modelo autorregresivo y a 64 en el fraccionario. Esa equivalencia no convierte el registro en una muestra independiente ni describe necesariamente la precisión de una mediana, de una tendencia o de una estimación espectral.
El cálculo supone que la media que se quiere estimar existe y es constante. Si el nivel medio cambia durante el registro, alargar la duración puede mezclar estados de funcionamiento distintos. La media de toda la muestra seguiría siendo calculable, aunque ya no estimaría el mismo objeto que la media constante del ejercicio. Elegir el horizonte depende, así, de una pregunta científica previa sobre qué cantidad se supone compartida por las observaciones que se quiere reunir.
Cabe preguntarse también qué ocurre si las lecturas horarias se reemplazan por promedios de bloques consecutivos, sin solapamiento para no crear dependencia adicional a través de observaciones compartidas. Cada promedio varía menos que una lectura individual, pero interesa saber si la relación entre bloques vecinos disminuye también. Así puede examinarse la persistencia después de cambiar la unidad temporal de la descripción.
En el ruido fraccionario, la suma dentro de cada bloque es un incremento del mismo movimiento browniano fraccionario. Por la autosimilitud, una vez normalizadas las amplitudes, la secuencia agregada conserva la estructura de correlación del modelo. En particular, la correlación entre dos promedios contiguos sigue siendo de unas cuatro décimas tanto si cada bloque contiene una observación como si contiene dieciséis o doscientas cincuenta y seis. Lo que se reduce es la amplitud, mientras la forma relativa de la dependencia se mantiene.
Para el autorregresivo inicial pueden sumarse directamente las covarianzas entre todas las parejas de dos bloques vecinos. Con dieciséis observaciones por bloque, la correlación entre promedios baja a cerca de ; con doscientas cincuenta y seis, a . La mayoría de las parejas quedan separadas por distancias a las que la correlación original ya es muy pequeña. Por eso los promedios de bloques grandes se acercan, en su dependencia de segundo orden, a observaciones incorrelacionadas.
Estas cuentas dan una forma concreta de entender el escalamiento temporal, sin que ello signifique que todas las propiedades de una serie sean idénticas al cambiar la resolución. Lo que se comprueba es una relación determinada entre las distribuciones de los incrementos y sus amplitudes. Una serie real puede cumplir esa relación de forma aproximada solo entre ciertos tamaños de bloque. Para comprobarla hay que conservar tanto la escala física de cada bloque como el número de bloques que quedan disponibles. Por otra parte, la agregación no recupera información sobre fluctuaciones más rápidas que el intervalo de observación original.
Colas producidas por agregación
Una misma dependencia de largo alcance puede proceder de arquitecturas diferentes. Granger (1980) estudió la relación entre memoria larga y agregación de modelos dinámicos. Esa relación puede ilustrarse con una construcción sencilla de covarianzas en la que se combinan componentes autorregresivos independientes, cada uno con varianza normalizada y un coeficiente de persistencia propio. Una combinación finita de componentes con coeficientes estrictamente menores que uno mantiene una cola sumable.
Un límite continuo puede comportarse de otro modo si admite componentes con persistencias cada vez más cercanas a uno. Consideremos una mezcla de covarianzas con densidad entre cero y uno, que integra uno. La correlación agregada queda definida por
donde la función beta expresa esa integral. Es una covarianza válida porque combina covarianzas válidas con pesos positivos. Su cola es proporcional a . Ningún componente individual tiene coeficiente exactamente igual a uno, pero tampoco hay una escala máxima finita de relajación que limite al conjunto.
La construcción describe una superposición de componentes, o un proceso definido por la covarianza resultante. Sortear una única persistencia al comienzo de cada trayectoria sería otro modelo, que compartiría algunas propiedades de segundo orden, pero plantearía preguntas distintas sobre lo que puede estimarse dentro de una realización. Especificar cómo se forma la mezcla importa tanto como escribir la distribución de sus coeficientes.
En un registro de duración limitada, una mezcla finita de escalas puede imitar una cola de potencia durante un intervalo considerable, más allá del cual termina dominando su componente más lenta. Con los datos disponibles puede ser difícil distinguir el modelo continuo de la aproximación finita. La observación de escalamiento puede orientar la descripción de la dependencia sin establecer si el sistema físico contiene una jerarquía infinita de escalas.
El instrumento introduce otra mezcla aunque el proceso subyacente no cambie. Supongamos que al ruido fraccionario del ejemplo se suma un error de medición independiente entre lecturas e independiente del estado, con varianza nueve. La señal observada tiene entonces varianza diez. En los retardos distintos de cero su autocovarianza coincide con la del ruido fraccionario, porque los errores instrumentales no contribuyen a las parejas separadas. La autocorrelación, en cambio, queda dividida por diez al normalizarla con la nueva varianza marginal.
La correlación inmediata observada sería apenas . Quien mirara solo esa cifra podría describir la señal como casi independiente, aunque la cola de la covarianza conserve el mismo exponente. En la media de un registro, la varianza del error instrumental disminuye como nueve dividido por el número de lecturas y la del estado fraccionario más lentamente. Con dieciséis lecturas la varianza total es ; con 4.096 es de unos . En este segundo caso, la parte que procede del estado domina con holgura.
Promediar reduce con eficacia el error independiente, pero no vuelve independientes las fluctuaciones lentas del proceso. Esta diferencia puede producir un cambio de comportamiento entre escalas sin que la memoria del estado haya cambiado. Si la precisión instrumental se conoce por calibración, puede incorporarse explícitamente al modelo. Si se estima con la misma serie, reaparece un problema de separación entre la parte de la variación rápida que pertenece al instrumento y la que pertenece al fenómeno; el exponente no determina por sí solo esa partición.
Del rango acumulado a la fluctuación detrendida
Hurst (1951) estudió la capacidad de almacenamiento necesaria para compensar las fluctuaciones de caudal. Acumular las desviaciones respecto de una media convierte una secuencia de aportes en una trayectoria de excedentes y déficits. En aquel planteamiento, la diferencia entre el máximo y el mínimo de esa trayectoria es el rango que debe absorber el embalse. La idea de estudiar cómo crece una acumulación con la duración es anterior a las muchas variantes actuales de estimación del exponente de Hurst.
En el análisis de rango reescalado, ese rango acumulado se divide por una medida de dispersión de los datos originales y se examina para distintos tamaños de bloque. El cociente puede crecer de forma parecida a una potencia, aunque obtener una pendiente exige decidir sobre los bloques, el centrado y el intervalo de ajuste. La pendiente calculada es un estimador definido por esas decisiones y no una observación directa del parámetro de un proceso conocido.
El análisis de fluctuaciones detrendidas, o DFA, parte también de una acumulación. Primero se resta la media muestral y se forma el perfil . Después ese perfil se divide en segmentos de longitud , en cada uno se ajusta un polinomio y se conserva el residuo. Por último se promedian los cuadrados de todos los residuos y se toma la raíz cuadrada, que se denota .
El orden del DFA es el grado del polinomio ajustado al perfil; DFA1 ajusta rectas y DFA2 parábolas. Como la serie se acumula antes del ajuste, quitar una recta del perfil elimina una componente constante de la serie original. Una tendencia lineal original produce un perfil cuadrático que requiere DFA2 para eliminarse exactamente. Kantelhardt y colaboradores (2001) desarrollaron esta correspondencia, que se pierde si se pasa por alto la acumulación.
En los cálculos siguientes usaremos segmentos consecutivos sin solapamiento y descartaremos el resto incompleto. Otras implementaciones vuelven a segmentar desde el extremo opuesto para usar ese resto. Si la longitud es divisible por el tamaño del bloque, segmentar desde ambos extremos reproduce los mismos segmentos y no duplica la información independiente. El procedimiento concreto debe acompañar al exponente que se comunica.
Para el ruido fraccionario estacionario, la fluctuación cuadrática esperada escala asintóticamente con un exponente de amplitud igual a su parámetro de Hurst. Løvsletten (2017) estudia esta relación a partir de las covarianzas y de los pesos del detrendido, incluido el sesgo de tamaño finito. La equivalencia requiere las condiciones del proceso y un régimen de escalas apropiado. Si la entrada fueran los niveles del movimiento browniano fraccionario, el exponente DFA sería el de autosimilitud más uno, por lo que una pendiente mayor que uno no debe tomarse automáticamente como parámetro de memoria de una serie estacionaria.
Pendientes locales calculadas sin simulación
El DFA esperado puede estudiarse directamente a partir de la covarianza. Dentro de un segmento, la acumulación es una transformación lineal y el ajuste polinómico una proyección. Si es la covarianza de las observaciones y designa ambas operaciones, aplicadas para conservar solo el residuo, entonces
Para una entrada centrada, la igualdad usa momentos de segundo orden y no requiere simular ninguna trayectoria. La cantidad que compararemos es , que no coincide con la esperanza de porque tomar la raíz y promediar no conmutan.
Volvamos al autorregresivo de coeficiente y varianza estacionaria uno para compararlo con el ruido fraccionario de parámetro , ambos procesados con DFA1. Calcularemos pendientes locales entre cada tamaño de bloque y su doble, dividiendo el logaritmo del cociente entre amplitudes por el logaritmo de dos.
Entre las escalas treinta y dos y sesenta y cuatro, la pendiente del autorregresivo es de unos y la del fraccionario de . Entre quinientos doce y mil veinticuatro, los valores pasan a y , de manera que en ese intervalo una pendiente aislada distinguiría muy mal los dos modelos. De mil veinticuatro a dos mil cuarenta y ocho, el autorregresivo baja a mientras el fraccionario se mantiene prácticamente en tres cuartos.
El autorregresivo tiene memoria corta en todos esos cálculos. El desplazamiento de su pendiente corresponde a una transición entre escalas de un mismo proceso. No hubo un cambio de mecanismo entre segmentos ni se eligió una realización peculiar. Maraun, Rust y Timmer (2004) mostraron lo difícil que es distinguir memoria larga de alternativas de memoria corta con curvas DFA finitas, apoyándose en pendientes locales y en la variabilidad entre realizaciones para valorar esa ambigüedad.
En datos reales se añade la incertidumbre de estimación. Un registro de 4.096 puntos contiene ocho bloques no solapados de tamaño quinientos doce, pero solo dos de tamaño dos mil cuarenta y ocho, que además pueden estar relacionados entre sí. Añadir puntos a una curva logarítmica no crea realizaciones nuevas del proceso; las amplitudes calculadas a distintas escalas reutilizan las mismas observaciones. Los errores de una regresión lineal ordinaria sobre esa curva no representan automáticamente la incertidumbre del exponente.
Hay sesgo también en las escalas pequeñas, aun sin tendencia. Para ruido blanco de varianza uno, DFA1 da exactamente , que solo para segmentos grandes se acerca a una constante multiplicada por su longitud. Ajustar desde los segmentos más pequeños puede introducir una curvatura que se debe al propio procedimiento. Aumentar el orden del polinomio modifica los residuos y obliga a revisar de nuevo el rango de escalas utilizable.
Tendencias y cambios de nivel
Consideremos ahora ruido blanco independiente de varianza uno con una tendencia determinista de pendiente por lectura. El ruido no tiene memoria temporal, aunque la media del registro completo varía con el tiempo. Bajo DFA1, el perfil de la tendencia deja un residuo cuadrático cuya contribución exacta es
Las contribuciones del ruido y de la tendencia se suman en la esperanza de la fluctuación cuadrática porque el residuo aleatorio tiene media cero. En una realización concreta aparece además un producto cruzado, en general no nulo, que la independencia no permite borrar de cada muestra individual. Hu y colaboradores (2001) estudiaron cómo la competencia entre tendencias y fluctuaciones produce cambios aparentes de pendiente; aquí mantenemos separadas la identidad válida en esperanza y la que valdría para cada registro.
En segmentos de sesenta y cuatro lecturas, la amplitud cuadrática esperada del ruido es de unos y la de la tendencia apenas . En segmentos de mil veinticuatro, esas cifras pasan a y , con lo que la tendencia acaba dominando la curva aunque su incremento entre lecturas consecutivas parezca pequeño. DFA2 elimina exactamente esa componente lineal original bajo la construcción especificada, sin eliminar por ello cualquier otra forma de no estacionariedad.
Un cambio brusco de nivel plantea otra dificultad. Construyamos una serie determinista de quinientas doce observaciones en la que las primeras doscientas cincuenta y seis valen menos uno y las restantes más uno. Con bloques de sesenta y cuatro, el salto coincide con una frontera entre segmentos. Dentro de cada segmento la serie es constante y su perfil es lineal, así que DFA1 elimina por completo la contribución del cambio a esa escala.
Desplacemos ahora el salto dieciséis observaciones hacia atrás, con los mismos niveles. Uno de los segmentos contiene entonces ambos niveles y su perfil presenta un quiebre. La contribución media de la componente determinista a pasa de cero a cerca de , mientras que el mismo modelo de ruido blanco aportaría en esperanza . La posición del cambio respecto de los bloques altera sustancialmente el resultado sin introducir memoria alguna en las perturbaciones.
El ejemplo explica por qué conviene examinar el registro y su calendario además de la curva DFA. Un ajuste local puede absorber una discontinuidad cuando los segmentos quedan alineados con ella y conservarla cuando la frontera cae en otro sitio. Ninguna de las dos situaciones basta para establecer que exista una distribución estacionaria común. Probar distintos puntos de partida para la segmentación y documentar los cambios conocidos del instrumento ayuda a entender qué está quitando el detrendido.
Una tendencia estimada con los mismos datos añade incertidumbre sobre qué parte pertenece al nivel y qué parte a las fluctuaciones. Una curva lo bastante flexible puede absorber variación lenta que el modelo de memoria larga pretendía explicar. El análisis tiene que mantener a la vista la relación entre la hipótesis de tendencia y la dependencia residual. Comparar los resultados de varios procedimientos defendibles muestra cuánto depende la conclusión de esa separación.
Registrar lo que los datos permiten distinguir
Un análisis de escalamiento debe declarar la frecuencia de observación, la duración total y las transformaciones aplicadas a la serie. Eliminar una tendencia, tomar diferencias o interpolar ausencias cambia la dependencia que llega al estimador. Si el intervalo de muestreo varía, un retardo de diez índices puede no corresponder a diez unidades del mismo tiempo físico. La escala debe referirse al tiempo físico pertinente para la pregunta, que puede diferir de la posición de un dato en un archivo.
Después es útil confrontar modelos que representen las explicaciones plausibles del registro. Un proceso fraccionario, una persistencia autorregresiva lenta y una serie con cambios de nivel pueden dar indicios parecidos en un intervalo limitado. Simular desde los modelos ajustados permite repetir todo el procedimiento de análisis y examinar la variabilidad de las pendientes. Si los parámetros se estimaron, esa etapa también debe reflejarse en la evaluación, porque fijarlos en sus valores ajustados y tratarlos como conocidos reduce artificialmente las fuentes de incertidumbre consideradas.
El intervalo de escalas usado merece tanta atención como el exponente. Debe justificarse por la resolución disponible, por el comportamiento del procedimiento y por la cantidad de información que queda en los segmentos grandes. Elegir después de mirar los datos el tramo que parece más recto sesga el análisis a favor del resultado buscado, mientras que mostrar cómo cambian las pendientes locales y la conclusión al mover límites razonables de ajuste deja visible esa dependencia.
La concordancia entre una pendiente espectral, el crecimiento de las varianzas agregadas y el DFA puede dar coherencia a un modelo. Los tres cálculos usan, sin embargo, el mismo registro y responden a aspectos emparentados de su covarianza, por lo que no equivalen a tres experimentos independientes. Cuando las alternativas siguen siendo compatibles con la duración observada, una conclusión útil puede limitarse a describir la persistencia en un rango temporal y a cuantificar la precisión que esa dependencia permite.
Para los dos instrumentos iniciales, supongamos que se quiere reducir a la mitad la incertidumbre de una media calculada con doscientas cincuenta y seis lecturas. Si se conoce el modelo fraccionario especificado, la desviación inicial es un cuarto, la deseada un octavo y la duración necesaria de 4.096 lecturas. Con el modelo autorregresivo, la desviación parte de unos y multiplicar la duración aproximadamente por cuatro la reduce casi a la mitad. Antes de programar la adquisición adicional, el registro debe dejar constancia de cuál de esas hipótesis respalda el cálculo, porque una correlación de cuatro décimas entre horas consecutivas, sin información sobre la cola, no permite elegir entre ambos plazos.
Referencias
Granger, C. W. J. (1980). Long memory relationships and the aggregation of dynamic models. Journal of Econometrics, 14(2), 227–238. https://doi.org/10.1016/0304-4076(80)90092-5
Hu, K., Ivanov, P. Ch., Chen, Z., Carpena, P., & Stanley, H. E. (2001). Effect of trends on detrended fluctuation analysis. Physical Review E, 64(1), 011114. https://doi.org/10.1103/PhysRevE.64.011114
Hurst, H. E. (1951). Long-term storage capacity of reservoirs. Transactions of the American Society of Civil Engineers, 116(1), 770–799. https://doi.org/10.1061/TACEAT.0006518
Kantelhardt, J. W., Koscielny-Bunde, E., Rego, H. H. A., Havlin, S., & Bunde, A. (2001). Detecting long-range correlations with detrended fluctuation analysis. Physica A: Statistical Mechanics and its Applications, 295(3–4), 441–454. https://doi.org/10.1016/S0378-4371(01)00144-3
Løvsletten, O. (2017). Consistency of detrended fluctuation analysis. Physical Review E, 96(1), 012141. https://doi.org/10.1103/PhysRevE.96.012141
Mandelbrot, B. B., & Van Ness, J. W. (1968). Fractional Brownian motions, fractional noises and applications. SIAM Review, 10(4), 422–437. https://doi.org/10.1137/1010093
Maraun, D., Rust, H. W., & Timmer, J. (2004). Tempting long-memory: On the interpretation of DFA results. Nonlinear Processes in Geophysics, 11(4), 495–503. https://doi.org/10.5194/npg-11-495-2004