Módulo 28. Juegos evolutivos y cooperación
1. La respuesta a una equivocación cambia el juego
Una pareja de estrategias puede mantener cooperación indefinidamente cuando las acciones se ejecutan sin errores. Esa observación dice poco sobre lo que ocurrirá después de una equivocación. Un fallo aislado puede corregirse en dos rondas o desencadenar una secuencia de represalias que dure toda la relación. La diferencia depende de cómo cada estrategia interpreta y usa la historia.
Conviene separar errores de ejecución y errores de observación. En el primer caso, un jugador intenta cooperar y ejecuta la acción contraria. En el segundo, la acción ocurre como estaba prevista, pero el compañero la percibe incorrectamente. Un modelo que trate ambos errores como una sola probabilidad puede perder información importante, especialmente cuando cada jugador conserva una historia privada de lo sucedido.
También hay incertidumbre sobre la intención. Una defección observada puede ser deliberada o accidental. Si la estrategia responde de la misma manera en ambos casos, puede castigar una equivocación como si fuera explotación. Tolerar toda defección, en cambio, abre oportunidades a quienes se aprovechan de esa tolerancia. El problema es responder a información imperfecta, algo más exigente que elegir entre severidad y benevolencia.
La memoria disponible limita las respuestas posibles. Una regla puede recordar solo la última acción del compañero, el último resultado conjunto o una secuencia más larga. Recordar más permite distinguir historias que una memoria breve confunde, pero puede exigir recursos y dificultar el aprendizaje de la regla. La complejidad de la estrategia no garantiza un mejor resultado en todos los ambientes.
Este capítulo comparará estrategias sencillas mediante una cadena de Markov de cuatro estados. El cálculo permitirá separar el comportamiento transitorio del promedio a largo plazo. Usaremos errores de ejecución independientes y pagos de donación con beneficio tres y costo uno. Son supuestos deliberados; con observaciones privadas, acciones alternadas o errores correlacionados haría falta otra descripción.
La comparación se centrará en cómo se recupera la cooperación y qué costos produce el ruido. No intentaremos declarar una estrategia universalmente superior. El desempeño depende de los compañeros presentes, de la duración de las relaciones y de la regla que transforma pagos en reproducción o aprendizaje. Una estrategia puede obtener buenos resultados consigo misma y ser vulnerable frente a una alternativa particular.
2. Dos reglas que utilizan la última ronda
La estrategia tit-for-tat comienza cooperando y después copia la acción anterior del compañero. Si el otro cooperó, coopera; si el otro no cooperó, tampoco lo hace. La regla no necesita recordar toda la relación. Sin errores, dos jugadores que la usan permanecen en cooperación mutua desde la primera ronda.
Una segunda regla, conocida como win-stay, lose-shift, conserva la acción después de un resultado satisfactorio y la cambia después de uno insatisfactorio. En el dilema que usaremos, consideraremos satisfactorios los pagos de cooperación mutua y de explotación unilateral, e insatisfactorios los de ser explotado y de defección mutua. Esta clasificación corresponde a un nivel de aspiración situado estrictamente entre cero y dos en nuestra escala de pagos.
Si ambos cooperaron, el jugador mantiene C. Si cooperó y el otro no, cambia a D. Si no cooperó y el otro sí, mantiene D porque obtuvo la tentación de tres. Si ambos eligieron D, cambia a C. Parte de la literatura de juegos evolutivos llama también Pavlov a esta regla. Nowak y Sigmund estudiaron su desempeño en poblaciones de estrategias probabilísticas [1].
Para describir cualquier estrategia de memoria de una ronda, ordenemos los resultados anteriores como CC, CD, DC y DD desde la perspectiva del jugador focal. La primera letra es su propia acción. Una estrategia queda especificada por cuatro probabilidades de cooperar en la siguiente ronda y una regla inicial. Tit-for-tat tiene el vector uno, cero, uno, cero; win-stay, lose-shift tiene uno, cero, cero, uno.
Recordar la acción ajena y recordar el resultado conjunto llevan a respuestas distintas. Después de DC, tit-for-tat coopera porque el compañero cooperó; win-stay, lose-shift continúa con D porque su propio resultado fue favorable. Después de DD, la primera mantiene D y la segunda cambia a C. Esas dos diferencias explican gran parte de su respuesta al ruido.
Para implementar una estrategia hay que indicar, además de su nombre, qué pagos se consideran satisfactorios, qué ocurre en la primera ronda y cómo se trata una acción ejecutada por error. Aquí la memoria registra las acciones realmente ejecutadas; si registrara las intenciones, la secuencia posterior podría ser distinta. La implementación forma parte del modelo científico.
3. Qué ocurre después de un solo error
Imaginemos dos jugadores tit-for-tat que han cooperado durante varias rondas. En una ronda, uno ejecuta D por error y el otro coopera. Desde una perspectiva fija, el estado es DC. En la ronda siguiente, el primero copia la C del compañero y el segundo copia la D que observó, de modo que el estado cambia a CD.
Si no hay nuevos errores, la ronda posterior vuelve a DC y los jugadores alternan quién coopera y quién no. Cada uno responde fielmente a la última acción ajena, pero la pareja no recupera la cooperación mutua. La regla que castigaba la explotación también conserva el efecto de la equivocación inicial.
Si ambos ejecutaran D por error en la misma ronda, los dos responderían con D y la defección mutua se mantendría mientras no ocurriera otro error. No todos los fallos producen la misma trayectoria, pero los dos ejemplos muestran que el carácter recíproco de la regla no garantiza la recuperación.
Consideremos ahora dos jugadores win-stay, lose-shift. Después de una equivocación unilateral, quien cooperó recibió el pago insatisfactorio menos uno y cambia a D. Quien no cooperó recibió tres y mantiene D. La siguiente ronda es DD. Ambos obtienen entonces el pago insatisfactorio cero y cambian a C. La ronda posterior vuelve a CC.
La recuperación requiere dos rondas adicionales sin errores después de la perturbación unilateral. La secuencia pasa por una ronda de defección mutua, pero no queda atrapada allí. Si el error inicial fue bilateral y produjo DD, la recuperación a CC ocurre en la ronda siguiente, siempre que las acciones se ejecuten correctamente.
Esta comparación no hace de win-stay, lose-shift una regla moralmente más tolerante. Su respuesta depende de la satisfacción con el resultado propio, de modo que puede mantener la defección cuando esta produce un pago alto. En términos funcionales, el ejemplo muestra que una misma regla local puede corregir ciertos errores y explotar ciertas oportunidades.
La diferencia también depende de que las decisiones sean simultáneas. Si los jugadores actúan por turnos y el segundo observa la acción actual del primero, cambian la información disponible y la secuencia de respuestas. Las conclusiones de un modelo simultáneo no deben transferirse automáticamente a intercambios alternados.
Estas trayectorias breves ya muestran que la recuperación de la cooperación depende de qué estados conducen de vuelta a CC. El análisis de probabilidades mostrará cuánto tiempo ocupa cada estado cuando los errores son recurrentes.
4. Construir la cadena de Markov
Sea p la estrategia del jugador focal y q la del compañero, ambas expresadas como probabilidades de cooperar después de los cuatro estados. Si cada acción intencionada se invierte con probabilidad épsilon, independientemente entre jugadores y rondas, la probabilidad efectiva de cooperar es
Una intención de cooperar se cumple con probabilidad uno menos épsilon; una intención de no cooperar produce C con probabilidad épsilon. Consideraremos épsilon estrictamente entre cero y un medio.
La perspectiva del compañero requiere atención. Cuando el estado focal es CD, el compañero observa DC. Por eso sus probabilidades deben consultarse en el orden CC, DC, CD, DD. Si olvidamos intercambiar las dos posiciones centrales, calcularemos con una estrategia distinta de la declarada.
Llamemos a y b a las probabilidades efectivas de cooperación de los dos jugadores después de un estado dado. La fila correspondiente de la matriz de transición es
Sus componentes son las probabilidades de CC, CD, DC y DD en la ronda siguiente. Suman uno porque enumeran todas las combinaciones posibles de dos decisiones binarias independientes, condicionadas al estado anterior.
Con errores positivos menores que un medio, cada componente de cada fila es positiva para las estrategias deterministas consideradas. La cadena puede pasar entre todos los estados y tiene una distribución estacionaria única. Si v es un vector fila con esas probabilidades, satisface v igual a vM y la suma de sus componentes es uno.
Los pagos medios se calculan ponderando los pagos de cada estado. Para el jugador focal, el vector es dos, menos uno, tres y cero; para el compañero se intercambian los pagos centrales. La frecuencia de cooperación focal es la probabilidad de CC más la de CD. Esta distinción entre estados conjuntos y acciones individuales evita confundir cooperación mutua con cooperación total.
La representación mediante estrategias de memoria de una ronda y matrices de transición aparece en análisis formales del dilema repetido, incluido el trabajo de Press y Dyson [2]. Aquí usaremos solo esa contabilidad de estados; no necesitaremos sus resultados específicos sobre restricciones lineales entre pagos.
La cadena describe la interacción de dos estrategias fijas; la evolución de sus frecuencias en una población queda fuera de ella. Para dar ese paso, los pagos resultantes deberán incorporarse a otro proceso de selección, imitación o aprendizaje.
5. El promedio a largo plazo de tit-for-tat
Cuando ambos jugadores usan tit-for-tat y los errores de ejecución son simétricos e independientes, la distribución estacionaria de los cuatro estados es uniforme y cada estado tiene probabilidad un cuarto. Puede comprobarse observando que tanto las filas como las columnas de la matriz de transición suman uno. Por ello, el vector uniforme satisface la ecuación estacionaria.
La frecuencia individual de cooperación es un medio. El pago medio de cada jugador es la cuarta parte de la suma de dos, menos uno, tres y cero, es decir, uno. Este resultado se mantiene para cualquier error positivo del intervalo considerado, aunque la rapidez con que se alcanza el régimen estacionario depende del error.
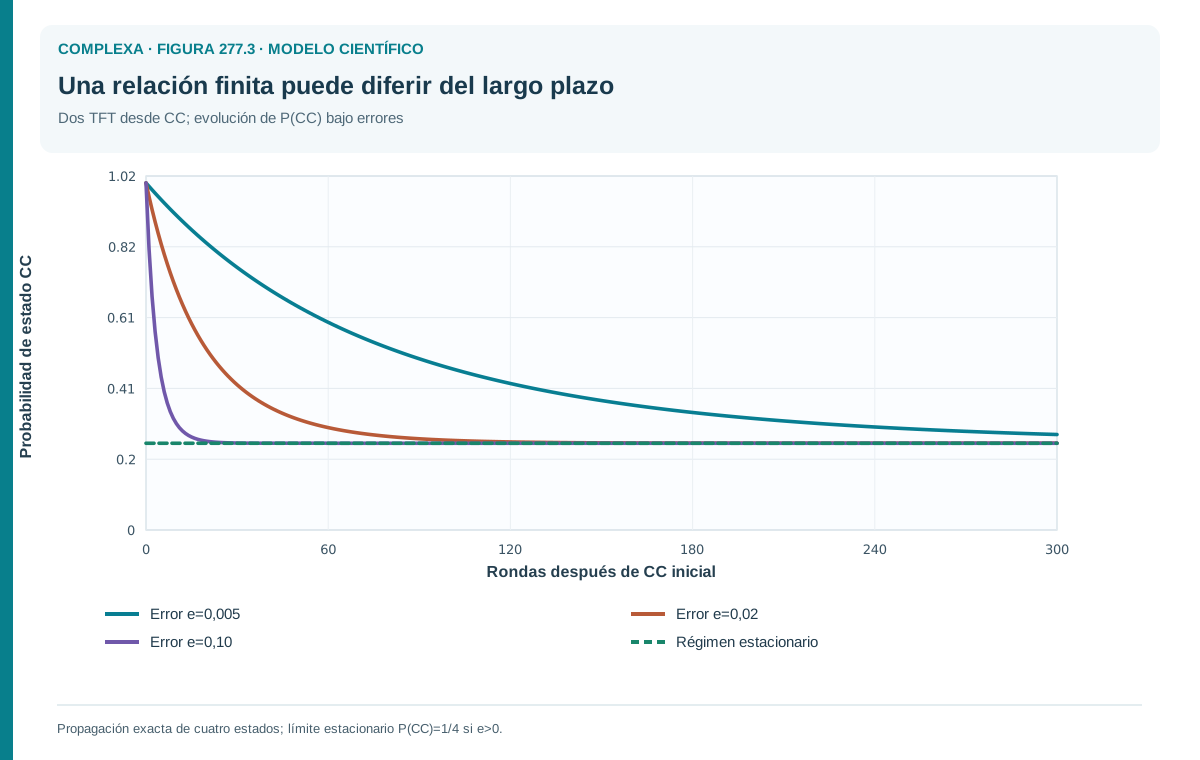
La conclusión puede parecer extraña cuando épsilon es muy pequeño. Si dos jugadores empiezan cooperando y casi nunca se equivocan, pueden pasar muchas rondas en CC antes de la primera perturbación, de modo que una relación breve puede parecer casi perfectamente cooperativa. El promedio estacionario describe una relación lo bastante larga para recorrer también estados de alternancia y defección mutua.
Los límites no son intercambiables. Si fijamos el error exactamente en cero y comenzamos en CC, permanecemos allí para siempre y el pago es dos. Si mantenemos cualquier error positivo, dejamos transcurrir el tiempo hasta alcanzar el promedio estacionario y después hacemos tender el error a cero, obtenemos pago uno. La diferencia surge porque el tiempo necesario para recorrer los estados aumenta cuando el error disminuye.
La probabilidad de que en una ronda ninguno de los dos jugadores cometa un error de ejecución es el cuadrado de uno menos épsilon. Con épsilon igual a cero coma cero uno, la probabilidad de al menos un error es cero coma cero ciento noventa y nueve. El número esperado de rondas hasta la primera ronda con algún error, contando esa ronda, es aproximadamente cincuenta coma veinticinco.
Una relación de diez rondas y una de diez mil no deberían resumirse mediante el mismo promedio estacionario sin examinar los transitorios. La probabilidad de atravesar diez rondas sin ningún error es cero coma noventa y nueve elevado a veinte, aproximadamente cero coma ochocientos dieciocho.
Podemos calcular también una medida que conserve el efecto de un comienzo cooperativo. Sea c subíndice t la probabilidad de que un jugador coopere en la ronda t cuando ambos usan tit-for-tat. Por simetría, la probabilidad de cooperación del compañero es la misma. Copiar su acción anterior y después sufrir una inversión con probabilidad e produce la recurrencia
Si ambos intentan cooperar en la primera ronda, c cero es uno menos e. La solución es un medio más un medio por uno menos dos e elevado a t más uno. El término adicional disminuye con el tiempo y describe la pérdida progresiva de la ventaja inicial de comenzar en cooperación mutua.
Al ponderar estas probabilidades mediante un descuento delta, la frecuencia cooperadora esperada normalizada es
Con error de uno por ciento y delta igual a cero coma nueve, esta frecuencia es aproximadamente cero coma novecientos quince y el pago esperado normalizado es aproximadamente uno coma ochenta y tres, claramente mayor que el promedio estacionario uno. Con delta igual a cero coma noventa y nueve, la frecuencia baja a aproximadamente cero coma seiscientos sesenta y cuatro y el pago a uno coma treinta y tres. Dar más peso a rondas lejanas incorpora más tiempo pasado en estados de conflicto.
Este resultado vale para parejas idénticas que empiezan cooperando, con errores simétricos recurrentes y sin mecanismos adicionales de reparación; de él no se sigue que prolongar las relaciones siempre perjudique a tit-for-tat. Lo que muestra con exactitud es qué cambia al pasar de una relación finita o descontada al régimen estacionario.
En este ejemplo, la vulnerabilidad de tit-for-tat procede de su respuesta a errores no corregidos, sin que eso implique una incapacidad general para sostener cooperación. Cambiar la regla para permitir perdón, reconocer errores propios o usar información adicional puede modificar la cadena. Cada modificación necesita su propia comparación frente a compañeros cooperadores y explotadores.
6. Recuperación y frecuencia estacionaria de cooperación
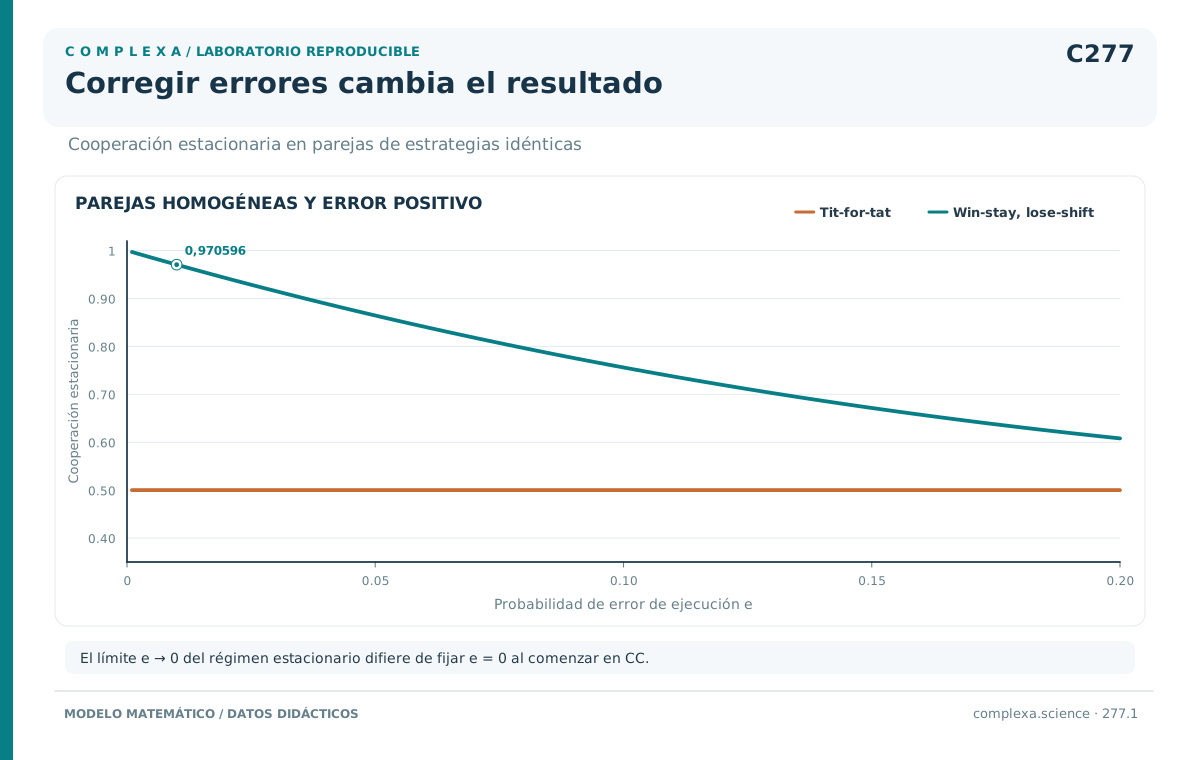
Para dos jugadores win-stay, lose-shift, los estados CC y DD conducen intencionalmente a CC en la ronda siguiente, mientras que CD y DC conducen intencionalmente a DD. Los errores alteran esas intenciones, pero la distribución estacionaria sigue siendo fácil de calcular.
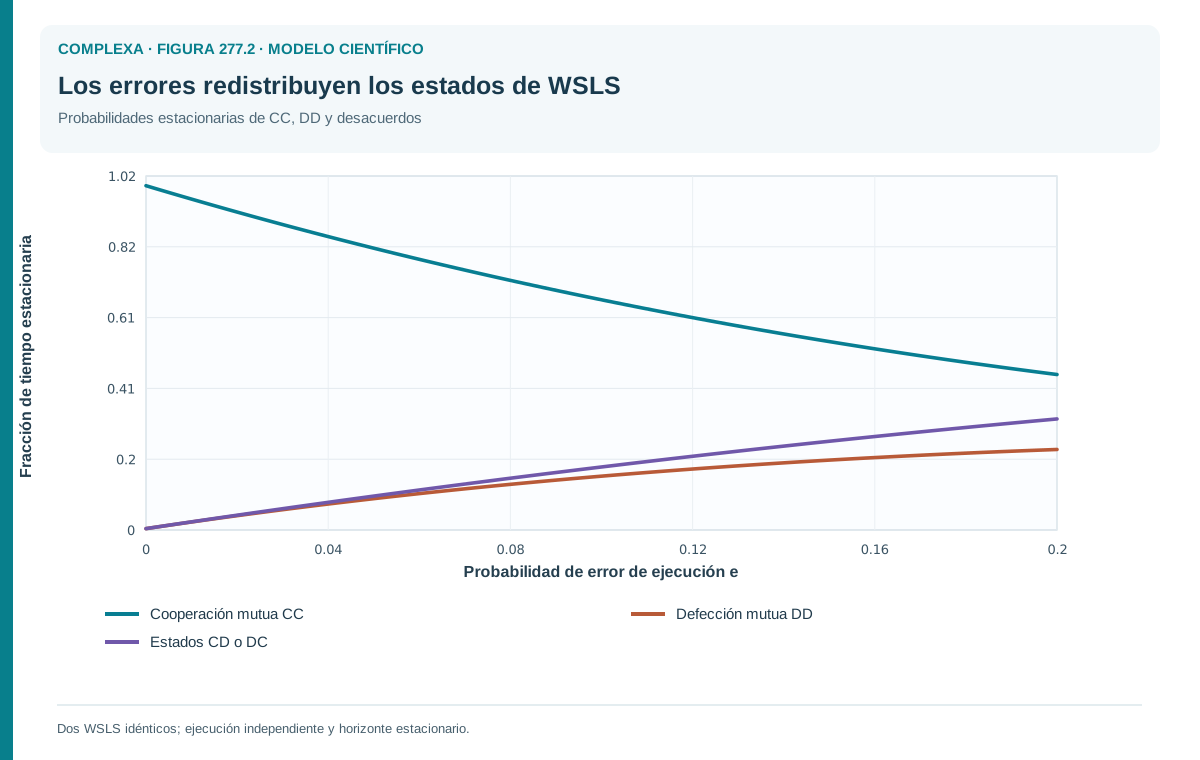
Denotemos por e la probabilidad de error y por a uno menos e. Después de un estado que prescribe CC, la distribución siguiente es a al cuadrado, ae, ae y e al cuadrado. Después de uno que prescribe DD, los componentes extremos se intercambian y la distribución es e al cuadrado, ae, ae y a al cuadrado.
Las probabilidades de CD y DC en la ronda siguiente son siempre ae, cualquiera que sea el estado actual. Por tanto, en el régimen estacionario cada una vale e por uno menos e. La probabilidad conjunta de esos estados descoordinados es dos e por uno menos e.
La probabilidad estacionaria de CC resulta y la de DD es
Al sumar la probabilidad de CC y la de CD obtenemos la frecuencia individual de cooperación,
Con e igual a cero coma cero uno, la frecuencia cooperadora es 0,970596 y la probabilidad de cooperación mutua es 0,960696.
Como ambos jugadores tienen la misma frecuencia de cooperación, el pago medio en el juego de donación es beneficio menos costo, multiplicado por esa frecuencia. Con beneficio tres y costo uno, resulta 1,941192, aproximadamente uno coma noventa y cuatro, que en este régimen supera el pago estacionario uno de tit-for-tat frente a sí mismo.
La comparación vale para emparejamientos homogéneos y para el largo plazo, así que aún no dice si una población win-stay, lose-shift resiste cualquier invasor ni si obtiene el mejor pago frente a una mezcla arbitraria de compañeros. Para eso necesitamos calcular los emparejamientos cruzados y considerar cómo se forman las parejas.
El cálculo muestra también una propiedad de robustez, pues la frecuencia estacionaria de cooperación tiende a uno cuando el error tiende a cero. Cuando los errores son raros, la recuperación después de las perturbaciones mantiene a la cadena cerca de CC la mayor parte del tiempo.
7. Cooperar consigo mismo y resistir explotación
Una estrategia que coopera siempre obtiene un pago alto cuando encuentra otra igual. Con error de ejecución e, cada jugador coopera con probabilidad uno menos e, independientemente de la historia. En nuestro juego, el pago medio de una pareja de cooperadores incondicionales es dos por uno menos e. Con e igual a cero coma cero uno, vale uno coma noventa y ocho, algo más que el de dos jugadores win-stay, lose-shift.
Ese resultado no convierte a la cooperación incondicional en una solución evolutivamente estable, porque frente a un compañero que nunca intenta cooperar seguirá pagando costos y dando beneficios. Su buen desempeño consigo misma debe compararse con lo que obtiene una alternativa cuando aparece entre esos cooperadores.
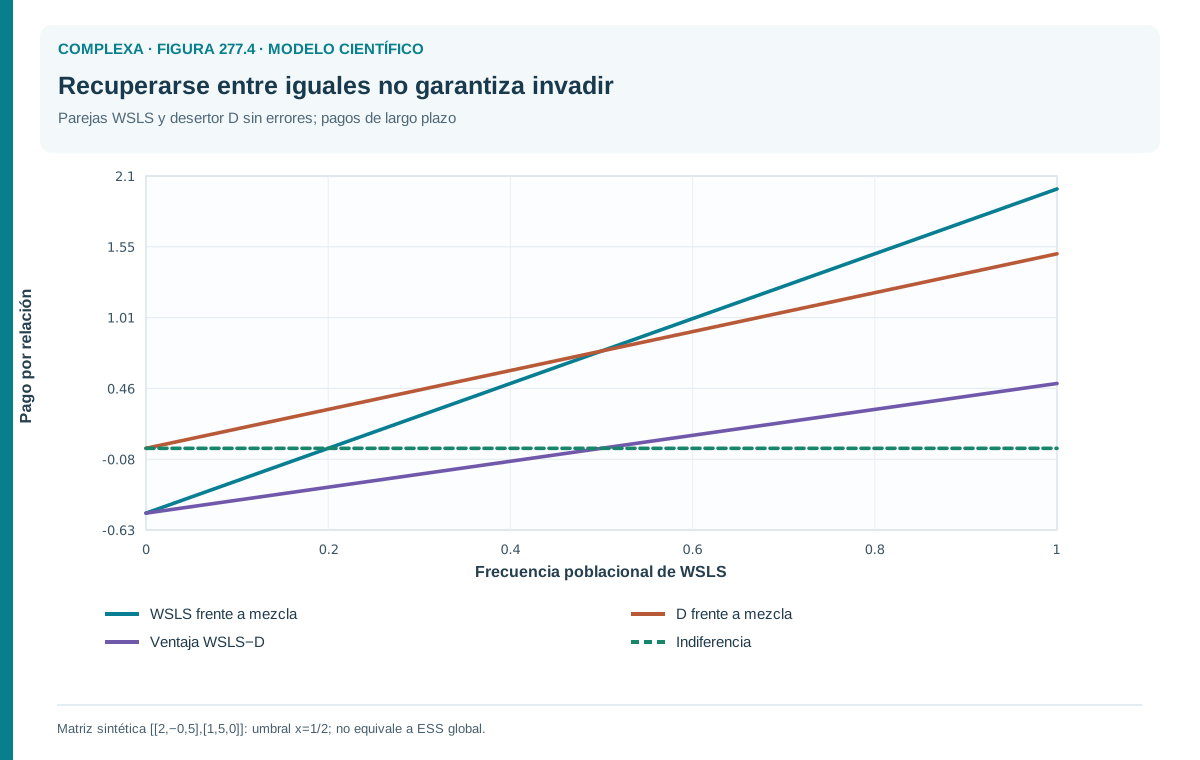
Win-stay, lose-shift también necesita esa prueba. Sin errores, frente a un jugador que siempre elige D, alterna entre cooperar y no cooperar. Después de ser explotado cambia a D; después de la defección mutua cambia a C. Su pago medio de largo plazo es menos un medio, mientras el compañero obtiene uno coma cinco. La regla que corrige errores entre iguales también queda expuesta a la explotación de este adversario.
Sin embargo, en una población casi enteramente win-stay, lose-shift, los residentes obtienen aproximadamente dos entre sí. Un D raro obtiene uno coma cinco frente a ellos en este límite sin errores. Por tanto, D no tiene ventaja cuando es raro en esa comparación concreta. Un residente aislado sale perdiendo frente a D, pero ese hecho solo no decide si una población de residentes es invadible.
En el juego de donación general, con esta alternancia y un horizonte largo, el residente obtiene b menos c frente a sí mismo y un D obtiene b dividido por dos frente al residente. La resistencia estricta a ese invasor requiere b mayor que dos c, condición que se cumple con b igual a tres y c igual a uno. Si el beneficio fuera uno coma cinco, dejaría de cumplirse aunque siguiera siendo mayor que el costo.
La comparación con cooperadores incondicionales plantea otro caso. Sin errores y comenzando en cooperación, ambas reglas pueden producir exactamente la misma secuencia. Esa igualdad impide declarar una ESS estricta solo a partir de la resistencia frente a D. El repertorio de alternativas y el tratamiento de las perturbaciones vuelven a ser decisivos.
Una evaluación adecuada necesita la matriz completa de pagos entre estrategias. Los elementos diagonales describen cómo se comporta cada tipo consigo mismo; los de fuera de la diagonal describen explotación, coordinación y recuperación entre tipos diferentes. Mirar solo la diagonal puede producir una clasificación engañosa.
8. Memoria, perdón y costo de complejidad
Una forma de modificar tit-for-tat es cooperar ocasionalmente después de una defección del compañero. Ese perdón puede romper secuencias de represalias, aunque también puede aumentar el pago de un compañero que deliberadamente no coopera. La probabilidad adecuada depende de la frecuencia de errores, de los tipos presentes y de la duración de la relación.
Otra posibilidad es distinguir los errores propios de las defecciones ajenas. Si un jugador sabe que se equivocó por accidente, puede evitar interpretar la respuesta del compañero como una nueva agresión. Esta regla, que no equivale a aumentar indiscriminadamente la probabilidad de cooperar, requiere acceso a información sobre la intención propia y una política de reparación.
Una memoria más larga puede detectar patrones que la última ronda no revela. Dos historias pueden terminar en DD aunque una proceda de un error reciente y otra de explotación persistente. Una estrategia de memoria de una ronda las trata igual; una regla que recuerde varias rondas puede diferenciarlas, siempre que los registros sean fiables y que la distinción mejore las decisiones.
El número de historias posibles crece rápidamente con la memoria. Si cada ronda tiene cuatro resultados conjuntos, recordar dos rondas permite dieciséis historias y recordar tres permite sesenta y cuatro. Una estrategia completamente libre podría asignar una probabilidad distinta a cada historia. Eso aumenta la capacidad descriptiva, pero también los datos necesarios para estimarla y las oportunidades de sobreajuste.
Milinski y Wedekind estudiaron la cooperación humana en un dilema repetido con una tarea secundaria que interfería con la memoria de trabajo [3]. En sus condiciones experimentales encontraron cambios en las estrategias usadas. El estudio ilustra que los recursos cognitivos pueden afectar la implementación de reglas de cooperación. De él no se sigue que una capacidad mayor produzca siempre más cooperación ni que una estrategia matemática describa de manera exhaustiva el razonamiento de cada participante.
En un modelo evolutivo, el costo de memoria podría restarse del pago obtenido en las interacciones. En un modelo psicológico, podría aparecer como errores de recuperación, tiempo de decisión o dependencia de señales externas. Esas representaciones no son equivalentes y deben elegirse según la pregunta.
La simplicidad puede ser ventajosa cuando permite responder con fiabilidad a información limitada; la memoria adicional, cuando distingue situaciones relevantes. La comparación debe incluir ambos efectos, sin suponer de antemano que una regla más compleja es superior o que una regla sencilla basta para cualquier ambiente.
9. Cómo comprobar un cálculo o una simulación
La representación de cuatro estados permite hacer comprobaciones concretas. Cada fila de la matriz debe sumar uno y contener probabilidades no negativas. La estrategia del compañero debe evaluarse desde su propia perspectiva, intercambiando CD y DC. Si estos pasos fallan, una simulación puede producir resultados plausibles que correspondan a un juego distinto.
Los componentes de la distribución estacionaria deben sumar uno y el producto de esa distribución por la matriz de transición debe reproducir el mismo vector. Conviene comprobar el residuo de esa ecuación. Un vector aproximadamente normalizado que no sea estacionario puede dar pagos medios incorrectos, especialmente cuando la convergencia es lenta.
También conviene examinar límites conocidos. Con error exactamente cero, dos tit-for-tat que empiezan en CC deben permanecer allí. Dos win-stay, lose-shift deben recuperar CC después de la secuencia unilateral descrita. Con error igual a un medio, las acciones efectivas se vuelven independientes de las intenciones y cada estado tiene probabilidad un cuarto. Estos casos son controles interpretables.
El régimen estacionario no reemplaza un cálculo para horizonte finito. Si v cero describe la primera ronda, la distribución de la ronda t es v cero multiplicado por M elevado a t. Un pago descontado normalizado se obtiene sumando esas distribuciones con pesos uno menos delta por delta elevado a t. Esta operación conserva la influencia del comienzo cuando las relaciones son breves.
La comparación entre simulación y cálculo exacto debe usar el mismo horizonte, las mismas condiciones iniciales y el mismo mecanismo de error. Si una simulación introduce errores de observación mientras la matriz modela errores de ejecución, la discrepancia puede ser conceptual, ajena a cualquier error numérico. Registrar estas decisiones evita corregir el programa para que coincida con una teoría que describe otro proceso.
En simulaciones aleatorias, una única trayectoria no da el promedio esperado. Varias repeticiones permiten estimar la variabilidad, pero muchas rondas correlacionadas dentro de una trayectoria no equivalen a muchas observaciones independientes. Cerca de un régimen con mezcla lenta, esa dependencia puede ser especialmente fuerte.
Finalmente, hay que conservar los resultados de los emparejamientos cruzados. Una tabla de pagos entre estrategias permite reconstruir la dinámica poblacional posterior y comprobar qué comparación produce una ventaja. Sin esa tabla, un resultado agregado de cooperación puede ocultar quién obtiene los beneficios y qué tipo está aumentando.
10. Robustez como propiedad del proceso completo
El análisis con errores cambia la pregunta sobre cooperación. Además de saber si una pareja mantiene CC en ausencia de perturbaciones, importa cuánto tarda en recuperarse, qué estados visita durante la recuperación y cuántos beneficios pierde antes de volver. Dos reglas con el mismo comportamiento ideal pueden diferir ampliamente en esas propiedades.
Tit-for-tat y win-stay, lose-shift muestran esa diferencia bajo errores de ejecución independientes. La primera puede conservar alternancias de represalia y, en el ejemplo simétrico, tiene una distribución estacionaria uniforme. La segunda vuelve a la cooperación después de errores aislados y mantiene una frecuencia alta cuando el ruido es pequeño. Estas conclusiones dependen de las reglas y del horizonte especificados.
La comparación no resuelve el problema de invasión. Una estrategia puede recuperarse bien frente a sí misma y dar oportunidades a otras. La matriz de emparejamientos, la composición poblacional y la forma de transmisión determinan si su buen desempeño se traduce en expansión. La robustez de una relación y la estabilidad evolutiva de una población son propiedades relacionadas, pero requieren pruebas distintas.
La memoria también debe evaluarse dentro del proceso completo. Recordar más puede permitir reparación selectiva, aunque implique costos o errores. Recordar menos puede facilitar una regla fiable, aunque confunda historias relevantes. Los modelos ayudan a identificar qué información necesita una respuesta; los experimentos pueden evaluar si esa información está disponible y se usa.
Para estudiar una interacción real conviene comenzar por los errores que efectivamente ocurren. Un fallo técnico, una percepción equivocada y una intención oportunista no generan necesariamente las mismas señales. Si el modelo los reúne bajo una sola probabilidad, debe justificar que esa reducción conserva las comparaciones importantes.
Los próximos capítulos ampliarán el foco hacia bienes públicos e instituciones. Allí, además de responder a la conducta de un compañero, habrá que coordinar contribuciones, financiar mecanismos de vigilancia y distribuir costos de sanción. De este capítulo retenemos que una regla de cooperación debe evaluarse también por lo que sucede cuando la información y la ejecución dejan de ser perfectas.
Referencias
- Nowak, M., y Sigmund, K. (1993). A strategy of win-stay, lose-shift that outperforms tit-for-tat in the Prisoner's Dilemma game. Nature, 364, 56–58. https://doi.org/10.1038/364056a0
- Press, W. H., y Dyson, F. J. (2012). Iterated Prisoner's Dilemma contains strategies that dominate any evolutionary opponent. Proceedings of the National Academy of Sciences, 109(26), 10409–10413. https://doi.org/10.1073/pnas.1206569109
- Milinski, M., y Wedekind, C. (1998). Working memory constrains human cooperation in the Prisoner's Dilemma. Proceedings of the National Academy of Sciences, 95(23), 13755–13758. https://doi.org/10.1073/pnas.95.23.13755